功能关键词:按关键词删除行、删除行号范围、清理TXT空白行、合并文本和去重。
工具介绍
批量TXT指定行删除工具从一个主文件夹收集TXT文件,按照是否包含关键词、字符数、原始行号、空白行规则排除内容,之后单独保存或合并为一个TXT文件。
本页面支持子目录范围、原始目录结构、合并后去重,并通过进度、日志、最终统计显示读取、删除、保留情况。可以同时使用多个删除规则。
工具截图
主要功能
- 从一个主文件夹批量读取.txt文件,并根据需要遍历子目录。
- 删除包含任一关键词的行,或删除不包含任何保留关键词的行,多个词用竖线分隔。
- 按照整行字符数的“大于”“等于”“小于”条件删除,或删除原始行号以及正数或负数行号范围。
- 单独删除空行和仅包含空白字符的行,并组合多个规则进行筛选。
- 按文件保存,并提供保留原始层级的选项,或合并到固定名称的合并结果.txt。
- 合并时可以对完全相同的行去重,处理后提供文件数和行数统计。
使用前的准备
请准备一个包含TXT文件的源主文件夹和一个现有的保存文件夹。本页面没有单文件选择列表、多来源分隔列表、用于另存为的文件名输入框。
关键词规则需要准备自己的词语,并用|分隔多个词;行号栏中显示支持1-5、10、-3等格式。字符数栏需要输入实际的正整数才能启用比较。
建议使用另一个空的保存目录,并保留原始文件。当前的单独保存不会完全检查派生的带编号名称是否重复,合并保存始终覆盖合并结果.txt;请勿将保存目录设置为源目录,或待遍历的源目录内的历史结果目录。
详细操作步骤
1. 选择主文件夹和保存目录,设置子目录范围
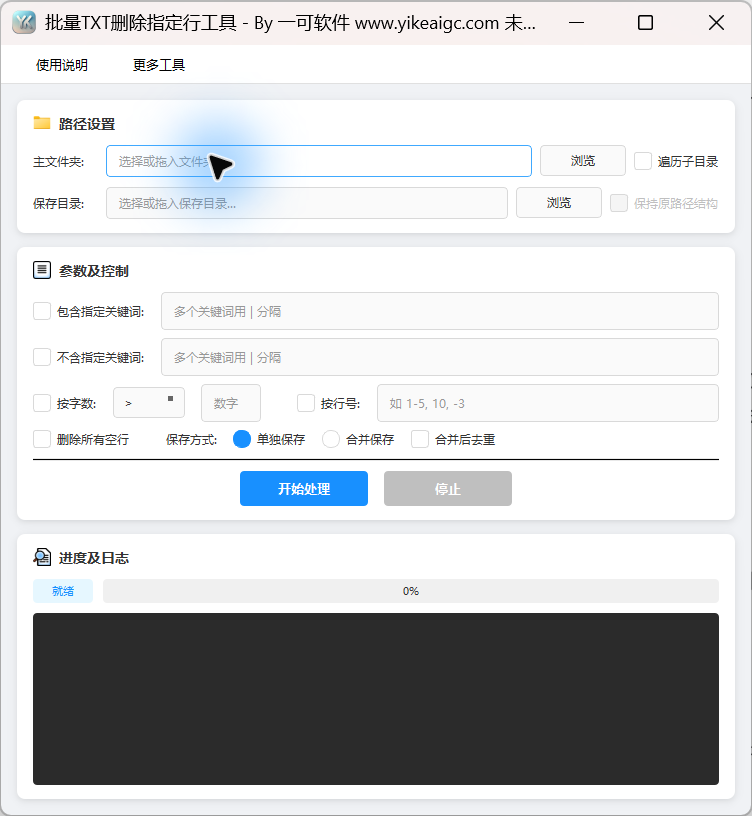
点击“路径设置”中“主文件夹”右侧的“浏览”,选择包含TXT文件的文件夹;点击第二行“保存目录”的“浏览”,选择现有的输出文件夹。两个输入框均用作目录。
也可以拖入文件夹;如果拖入文件,软件会获取其父目录,并处理该目录内的TXT文件,而不仅是拖入的文件。将来源拖到窗口空白区域时,也会按照此规则选择目录。
需要子文件夹时,选中“遍历子目录”后,“保留原始路径结构”将可用。保留结构仅在遍历并单独保存时影响输出,会将源主目录内的相对层级写入保存目录下。
如果仅选中遍历而不保留结构,结果将被扁平化。合并保存最终只写入一个文件,不会按各来源的层级拆分;输出目录不会自动从源扫描中排除,两个位置应当分开。
此图仅为展示相关设置而选中遍历并选择合并,来源和保存位置栏为空,未选择TXT文件、创建目录或读取素材。
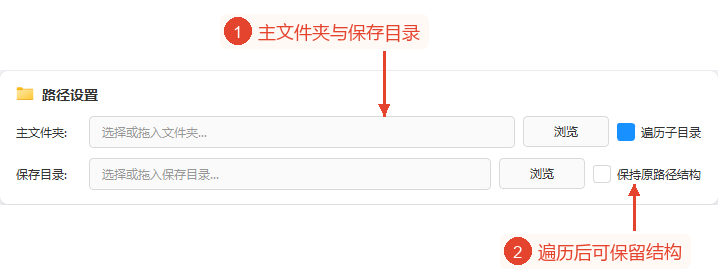
2. 根据需要启用包含或不包含关键词时的删除规则
要删除包含指定词的行,请选中“包含指定关键词”,并在右侧输入自己的关键词;多个词用|分隔,只要包含任一词,整行就会被删除。
要保留包含特定词的行,请选中“不包含指定关键词”,并输入自己的关键词列表;仅在不匹配任何词时才删除行,匹配任一词即可通过此筛选器。
匹配使用区分大小写的简单子字符串,不提供正则表达式、通配符、整词模式。各关键词首尾的空白会被去除,空的分隔部分会被忽略;未选中左侧规则时,即使输入文本也不会生效。
两个选项可以同时使用;保留的行必须包含“不包含”栏中的至少一个词,且不包含“包含”栏中的任何词。包括后续的行号、字符数、空白规则在内,只要匹配任一删除条件,行就会被删除,而不是只执行第一个选项。
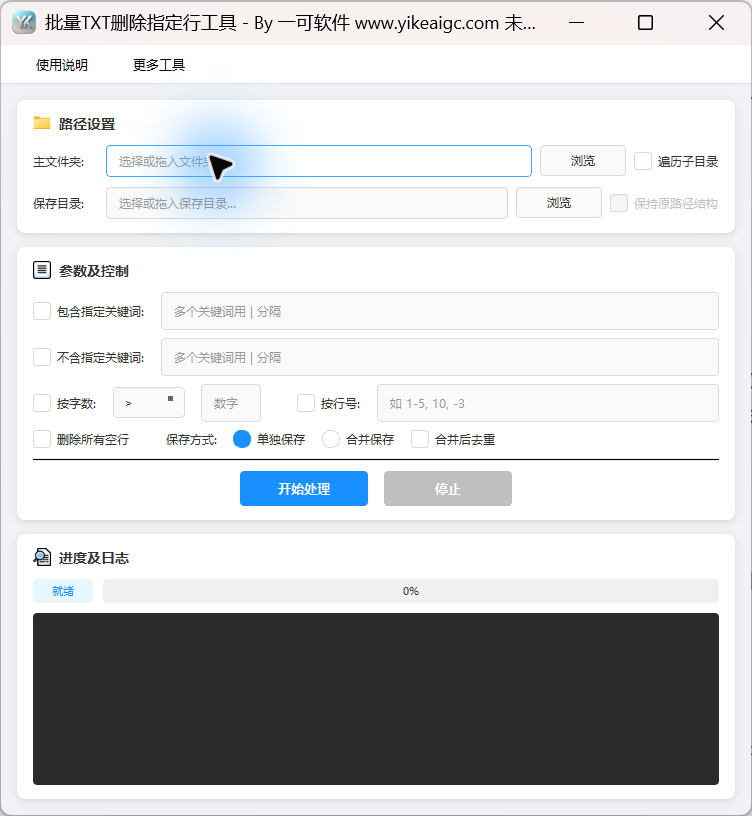
即使已选中,如果关键词仍为空,该选项实际上也不会进行筛选。截图中的关键词为空,选择状态仍为未选中,未输入测试词或执行筛选。
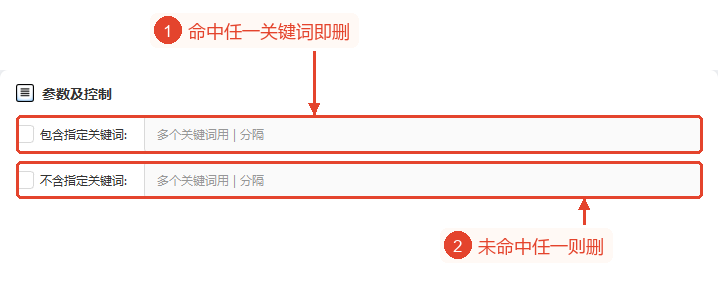
3. 设置字符数、原始行号、空白行规则
需要按长度删除时,请选中“按字符数”,在下拉框中选择>、=或<,并在“数值”栏输入自己的正整数。统计的是包括空格、标点、英文字母在内的整行字符,而不仅是汉字或单词,不包括已去除的行尾换行符。
要使其生效,值必须大于0。空值、无法转换为整数的值、0或负数会使长度筛选保持无效,页面不会显示单独的数值验证消息;如果只想删除空白行,请使用下方的专用选项。
选中“按行号”后,输入原始文件中从1开始的行号,用半角逗号分隔单独项目或范围。页面输入提示中显示的1-5表示第1行至第5行,10表示第10行,-3表示倒数第3行;-1为最后一行,也可以用负数范围表示末尾范围。
行号指各TXT文件的原始行序,在删除其他内容之前计算,不会因先前的关键词删除而重新编号。范围端点反向时会交换,超出范围的部分会被截断,重复的行号会被去重,0或无法解析的单独项目会被忽略。
选中“删除所有空白行”后,将删除空字符串以及去除首尾空白后变为空的行,也包括仅含空格或制表符的行。匹配其他规则的行也仍会被删除;即使所有规则都无效,文本仍会按照输出方式重写。
此图中的所有参数均为空,仅展示所显示的输入方法,未输入示例行号、长度或测试内容。
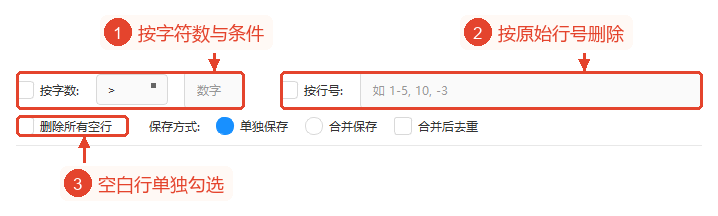
4. 选择单独保存或合并,根据需要启用合并时去重
“保存方式”默认为单独保存,为各来源生成同名的TXT文件;遍历并保留原始路径结构时,文件按相对层级保存,否则会被扁平化。遇到已有的基本名称时,会尝试名称(1).txt,对当前批次内的重复名称继续编号。
当前的编号仅检查基本名称和内部计数,不会循环确认所有派生名称均可用;如果名称(1).txt已经存在,或与其他来源的基本名称冲突,仍可能发生覆盖。建议每个批次使用空的输出目录,不应将编号理解为完整的同名保护。
如果需要一个合并文件,请选择“合并保存”。实际处理时,会将各来源中通过规则的行汇集到保存位置根目录的合并结果.txt,文件之间没有来源标题或自定义分隔符,内容顺序遵循文件任务的完成顺序,不保证文件名的字母顺序。
“合并后去重”实际上仅在合并保存期间使用,会从合并后的行集合中去除完全相同的行,保留最先找到的行;大小写或首尾空格不同的行会被视为不同的行。即使选中此选项,在单独保存期间也不会去重。
合并结果.txt始终使用写入模式,会覆盖保存目录中已有的同名文件,没有自定义名称或覆盖确认。图中仅选择了合并保存,去重仍未选中,未进行合并、文件写入或规则选择。
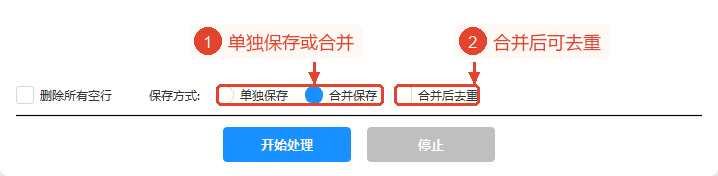
5. 实际开始后查看日志和统计,必要时停止
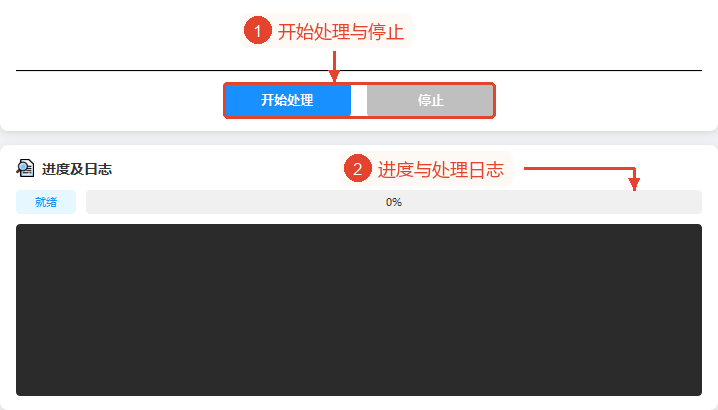
实际确认自己的源目录、空的保存目录、各删除规则、保存方式后,点击“开始处理”。软件首先在线重新验证使用权限,然后检查目录并启动任务;本文未点击开始,也未发起权限请求。
下方的“进度与日志”会显示扫描中、处理中、停止中、错误等状态及各文件的消息。内部使用固定数量的4个文件工作线程,页面没有线程数设置。
处理实际结束且已找到TXT文件时,会弹出“处理统计报告”,列出总文件数、处理成功、处理失败、读取总行数、删除行数、保留行数、删除率,确认后报告关闭。没有“导出报告”按钮,本教程也未为打开统计窗口而捏造数据。
统计中的删除行数和保留行数来自规则筛选,合并后去重减少的行不会额外计入删除统计;合并顺序、写入失败、停止也需要结合日志评估。单条完成日志或100%进度本身并不能证明所有文件均已写入且内容完整。
需要中断时,点击“停止”,软件会停止收集后续任务的结果,并尝试取消尚未开始的任务,但已经运行中的读取和筛选可能仍会完成。单独模式下已经写入的文件会保留;合并模式检测到停止后,当前累积的内容不会作为最终合并结果保存。
完成回调仍会将进度设置为100%,停止后,状态仍可能随后变为完成,并显示通用统计;这并不意味着所有对象都已处理完毕。请等待后台处理结束后再关闭程序;此外,页面未提供暂停或从检查点恢复。
结果会自动写入第二个步骤的目录,没有下载或打开结果按钮。当前处于0%就绪状态,日志为空,未进行读取、上传、删除源行、运行处理或验证结果;本次使用了快速制作模式。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 包含/不包含关键词 | 多个词使用|,采用简单子字符串并区分大小写。 | “包含”删除匹配任一词的行,“不包含”删除不匹配任何词的所有行;需要选中规则。 |
| 按字符数 | 使用>、=、<和正整数,统计整行字符。 | 包括空格和标点,不包括行尾换行;0或无效值不会进行筛选。 |
| 按行号 | 从1开始,使用逗号分隔列表、正数和负数范围,-1为最后一行。 | 为各文件的原始行序;超出范围或无效的单独项目不会导致错误。 |
| 删除所有空白行 | 也包括仅含空格或制表符的行。 | 独立于其他关键词条件和长度条件。 |
| 多个规则 | 匹配任一删除条件即去除。 | 同时启用两组关键词时,它们会共同限制保留的内容。 |
| 单独保存/合并保存 | 默认为单独保存;合并时始终写入合并结果.txt。 | 合并会覆盖,同名编号也不是完整的冲突规避。 |
| 合并后去重 | 实际上仅用于合并,按行文本完全一致去重。 | 不忽略大小写或两端空格,不保证源文件顺序。 |
| 路径结构 | 在遍历并单独保存时有效。 | 请使用另一个空的保存目录,以免再次扫描历史结果。 |
结果与保存
单独模式以来源名称保存TXT文件,保留结构时会复制来源内的相对层级;扁平化或已有的基本名称会使其尝试使用带括号的编号,但派生名称不会被完全检查,现有文件可能被覆盖。
合并模式始终在保存位置的根目录写入合并结果.txt,并覆盖同名文件。合并顺序来自并行任务的完成顺序,去重使用精确的行文本,不添加来源标题。
读取和写入均使用UTF-8,读取中的错误字符会被忽略,没有自动检测或手动选择编码;不应将GBK等来源直接作为UTF-8处理。每个输出行都会添加换行,无法承诺保留原始编码、字节、换行格式、文件末尾状态。
统计是规则筛选的行数,不包括合并时去重产生的额外删除,也不会自动导出;停止或写入错误需要结合日志评估。大文件按块读取,但仍会累积整个行列表,合并时也会累积要保留的行,不应将其理解为恒定内存用量的流式输出。
本次未处理TXT文件,也未生成合并结果或统计报告,上述为实际界面和源代码提供的保存方式。
常见问题与使用建议
1. 可以直接只选择一个TXT文件吗?
本页面选择的是主文件夹;拖入文件时,会获取其父目录并收集其中的TXT文件,不能将拖入一个文件视为只处理一个文件。
2. 为什么输入关键词后没有生效?
需要选中对应规则,空的关键词分隔部分会被忽略;简单匹配区分大小写,不支持正则表达式。
3. “不包含关键词”会删除匹配的行吗?
相反,仅在不匹配列表中的任何词时才删除行,匹配至少一个词即可通过此选项。
4. 多个规则会依次生成单独的输出吗?
不会,它们共同筛选相同内容,匹配任一删除规则即删除行,输出的是剩余内容。
5. 字符数0可以删除空白行吗?
长度仅在为正整数时生效,0不会生效;要删除仅含空白的行,请选中“删除所有空白行”。
6. 负数行号和删除后的行号如何计算?
-1为最后一行,-3为倒数第3行,始终遵循各文件的原始行序,不会因其他规则的删除而重新排序。
7. 选中“合并后去重”后,也会去除单独文件内的重复行吗?
不会,去重仅在合并保存期间进行,并严格区分大小写和空格。
8. 输出名称重复总能安全避免吗?
不能,单独模式不会完全检查派生名称,合并结果.txt会被覆盖,因此建议使用空的保存目录。
9. 可以选择GBK作为编码吗?
本页面没有编码选项,实际上会使用UTF-8读写并忽略解码错误,因此UTF-8以外的文本需要先自行整理编码。
10. 停止后的100%和统计表示完全完成吗?
不表示;这是因为回调会统一设置100%;单独保存中已经写入的内容会保留,停止合并后不会保存当前累积内容,统计也可能仅涵盖已收集的部分。