软件详情
QWEN3-ASR · 0.6B / 1.7B 本地语音转写
长录音、一整批视频,
一键变成文字稿与字幕
一场长会议反复听写,课程视频逐个配字幕,忙了很久还没整理完?想让本地大模型帮忙,却被环境安装、显卡配置和复杂命令挡住;电脑只有4G显存,或还在用老显卡,又担心无法开始。
Qwen3-ASR一键启动运行工具已内置Python、CUDA、cuDNN等所需环境,打开界面即可安排转写。支持N卡GPU与CPU,4G低显存、老显卡可用,提供1.7B与0.6B两种本地模型;从单份录音到整批超长音视频,选好素材后点击开始,文字稿与字幕自动生成。
01 · 功能介绍和特点
从录音听写,到成批字幕制作
不必逐个配置环境、逐份复制结果;把常用转写、输出和批次管理放在一个窗口。
一键启动,所需环境已内置
整合包内置Python、CUDA、cuDNN等所需运行环境,无需自己逐项安装和配置。打开工具,选择素材和输出位置,点击“开始转写”后自动运行,把时间留给内容整理。
N卡GPU与CPU,两种运行选择
有NVIDIA显卡时可使用GPU加速,没有独立显卡也能选择CPU转写。默认自动选择可用设备,同一套界面适配不同电脑;CPU处理通常更慢,适合按实际时间安排任务。
4G低显存、老显卡可用
为低显存和老N卡提供可调整的使用方式。建议优先选0.6B模型,关闭不需要的人声分离并缩短音频分段,先完成一段试转写,再安排长素材与批量任务。
1.7B与0.6B双模型,按任务选择
1.7B侧重精细识别,0.6B更轻量、省资源。界面中直接选择模型,不用更换整套工具;可根据录音清晰度、电脑配置和等待时间,挑选更合适的方案。
本地大模型运行,素材在本机处理
使用电脑中的本地模型识别音轨,文字稿和字幕保存到自己选择的目录,便于按项目管理。模型在任务开始时加载,空闲时可以释放占用,为其他软件腾出资源。
超长音视频转文字字幕,无需手动剪短
长会议、完整课程、访谈和直播回放可直接加入任务,软件自动连续处理并输出对应结果。无需先把素材剪成许多短文件,处理中可查看进度,停止后也能恢复已保存的进度。
多个文件与文件夹,批量自动处理
支持多选音频、视频,也能拖入文件和文件夹。确认模型、语言和输出内容后,一键依次处理整批素材,省去反复打开、等待和另存每份文件的操作。
30种语言与22种中文方言识别
模型覆盖30种语言和22种中文方言,可识别中文、英语、粤语、日语、韩语等内容。音频语言可自动识别或手动指定,适合不同来源的录音资料;字幕输出另有语言范围。
文字稿与时间轴字幕,按用途输出
会议整理可选TXT,视频制作可选SRT,也可同时生成两者;需要网页字幕时额外输出VTT,程序处理可输出带时间信息的JSON。一次任务准备多种结果,方便后续使用。
字幕长短可调,更贴合画面阅读
可调节每条字幕字数、显示时长和暂停阈值,并按标点分句。短视频可以缩短每条文字,课程字幕可适当放宽,减少生成后逐条拆分整理的工作。
识别前分离人声,应对明显配乐
素材带背景音乐时,可开启识别前分离人声,减少配乐对转写的干扰。干净的会议或访谈录音可关闭此项,节省处理时间和电脑资源,再按实际试听效果决定是否开启。
热词与上下文,辅助识别专有名称
填写人名、品牌名、专业术语或录音背景,为识别提供提示。常用热词可保存复用,适合持续处理同一项目的课程、会议和产品资料;关键名称仍建议对照录音核对。
保留目录层级,结果更容易归档
遍历子目录时可保留原有层级,让课程、章节和项目资料一一对应。已有同名文件自动编号,不覆盖旧结果;后续查找文字稿和字幕时更清楚。
断点恢复与失败重试,长批次可继续
可停止当前任务、恢复指定批次,或重试最近批次的失败和未完成项。已保存的进度保留,避免因中断就从头整理整批素材;CSV清单可查看状态、错误原因和结果位置。
结果预览、ZIP打包与API衔接
界面可预览或复制当前素材结果,完整文件保存到指定目录,成功结果可打包为ZIP。还提供API服务,供本机或局域网内的其他程序提交转写任务、查询进度和获取结果。
两种模型,选适合自己电脑的一种
0.6B · 轻量快速
优先考虑低显存、老显卡与日常转写。4G显存可先用此模型,关闭不需要的人声分离,试转写一份短素材后再扩大批量。
1.7B · 精细识别
适合更重视识别细节、电脑资源较充足的任务。可先用典型片段与0.6B比较,再根据结果和处理时间决定整批使用哪一种。
02 · 应用场景
把需要反复听写的内容,变成可整理的资料
为视频、课程、会议与采访准备文字和字幕,也方便后续查阅、编辑与归档。
自媒体与剪辑师 · 为视频批量生成字幕
将口播、采访和产品演示视频批量转成SRT,按竖屏阅读需要调整每条字数。导入剪辑软件后再校对文字和时间位置,为一组视频统一准备字幕素材。
教师与培训团队 · 整理超长课程资料
把完整课程、讲座和章节视频加入同一批次,生成文字稿与字幕。保留课程目录层级,方便按章节查阅、修订和交付,不用手动切成许多小文件。
企业与采访团队 · 录音转成可编辑文字
将会议录音、访谈和沟通记录转为TXT,先填入常见人名与专业词提示。转写后对照关键内容进行校对,再自行整理摘要、纪要或文章,减少反复听写。
资料整理与技术团队 · 建立批量转写流程
按项目扫描音视频文件夹,用CSV核对处理状态、用ZIP归集成功结果。需要与已有工具衔接时,可使用API提交任务,让素材转写融入日常处理流程。
03 · 使用说明
六步完成第一次转写,再交给整批任务
第一次建议使用一分钟左右的清晰素材,确认设备、语言和输出效果后再处理长文件。
下载整合包,打开启动工具
在Windows 10/11电脑上按包内说明完成解压或安装,保留完整配套目录,再打开Qwen3-ASR启动工具并登录。整合包已带所需运行环境;GPU运行时,请保持NVIDIA显卡驱动可用。
加入音频、视频或整个素材目录
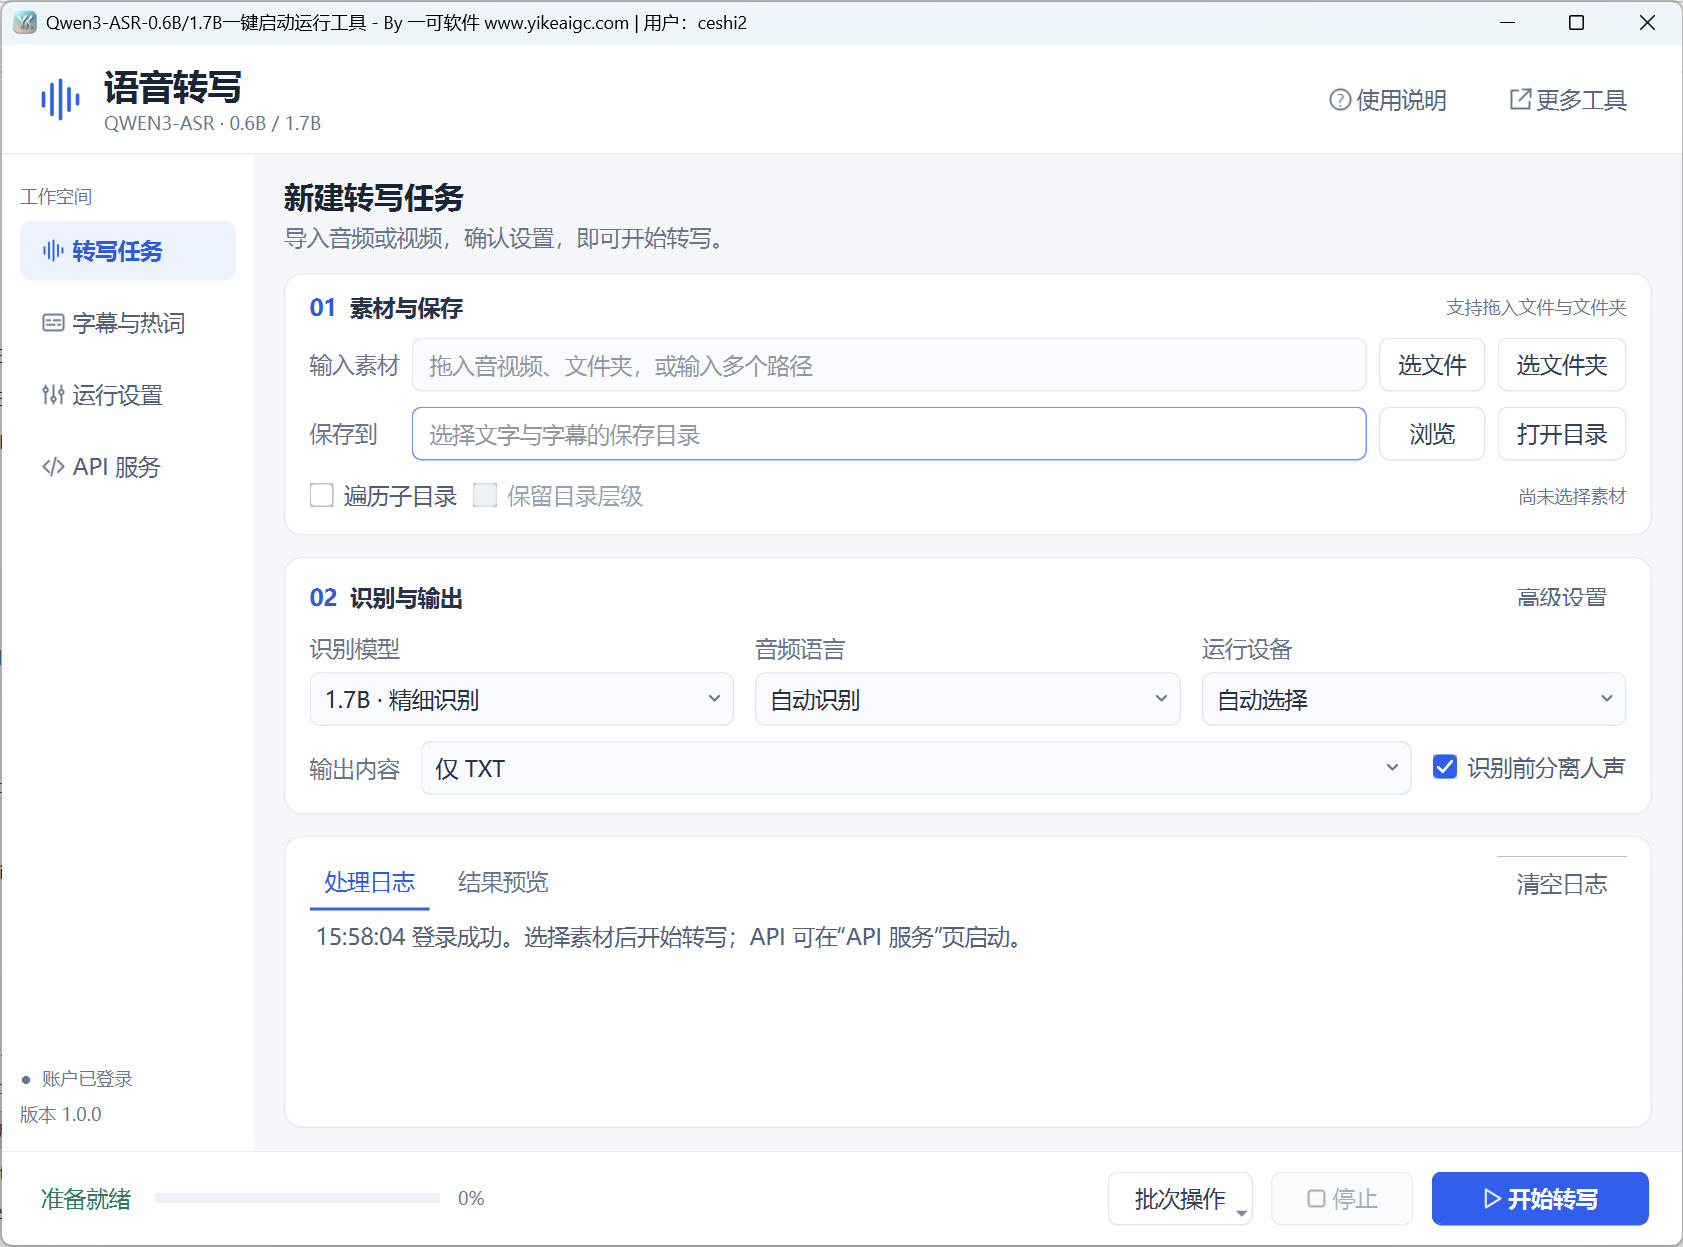
在“转写任务”中点击“选文件”多选素材,或点击“选文件夹”加入整个目录,也可以拖入。选择“保存到”目录;素材位于多级文件夹时勾选“遍历子目录”,按需开启“保留目录层级”。
选择模型、语言和运行设备
4G低显存或老显卡建议先选“0.6B · 轻量快速”;更重视识别细节且资源充足时可试“1.7B · 精细识别”。音频语言可自动识别或指定中文等语言,运行设备保留自动选择,也可手动选择GPU或CPU。
确定文字稿或字幕,补充热词
只整理录音文字时选择“仅TXT”;制作字幕时选择“仅SRT”或“TXT + SRT”。在“字幕与热词”设置字幕长度,填写人名和专业词;干净录音可关闭“识别前分离人声”,明显配乐素材再按需开启。
点击开始转写,等待自动处理
确认素材和保存目录后点击“开始转写”。首次使用需等待模型加载,长素材和批量任务会自动推进,可在日志与进度栏查看当前状态。低显存运行时,可在“运行设置”将音频分段从60秒调整为30秒。
检查结果,导出或继续未完成批次
在“结果预览”阅读并复制文字,通过“打开目录”查看完整TXT、SRT等文件。需要继续中断任务时,使用“批次操作 → 恢复批次”选择原批次记录;也可重试失败、导出CSV清单或打包结果ZIP。
常用任务,照着示例设置
4G显存与老显卡起步
0.6B模型 → 自动设备与精度 → 关闭人声分离 → 音频分段30秒 → 先输出TXT试用。需要字幕时,再确认语言并选择SRT或TXT + SRT。
会议录音转文字稿
加入M4A或WAV → 语言选中文 → 输出仅TXT → 填入常见人名与术语 → 开始转写。完成后打开完整文字稿,核对结论、金额和人名。
视频生成SRT字幕
加入MP4 → 输出TXT + SRT → 每条40字、最长6秒、暂停0.35秒 → 勾选按标点分句 → 开始转写。短视频可先尝试每条24字。
整套课程批量处理
选择课程文件夹 → 遍历子目录 → 保留目录层级 → 指定保存目录 → 开始转写。结束后用CSV核对结果,再把成功文件导出ZIP交付。
04 · 常见问题解答
4G显存、双模型和长音视频,常见疑问一次看清
点击问题即可展开答案,也可用键盘选择问题后按回车展开。
05 · 下载地址
下载Qwen3-ASR一键启动运行工具
支持Windows 10/11(64位) · N卡GPU与CPU · 4G低显存、老显卡可用 · 版本1.0.0
内置所需环境,1.7B与0.6B双模型可选。从一份录音开始,确认效果后,让整批超长音视频自动转成文字稿与字幕。
↓ 阿里云盘备用下载当前免费使用,需一可软件账号登录。主下载地址待补充,当前保留阿里云盘备用入口。下载后请按包内说明启动并保留配套文件。