专注批量处理软件

批量PDF保留排版翻译工具

批量翻译PDF并尽量保留多栏排版、公式、表格和图片,生成译文及双语对照PDF。支持扫描页OCR、多语言、指定页码、文件夹递归、在线PDF链接、多种翻译服务、失败重试与续处理,让论文、手册和技术资料更容易阅读与整理。

版本 1.0.0 更新于
OCR文字识别 PDF批量翻译 保留公式

获取软件

软件版本 · 1.0.0

首次使用?查看运行指南

软件详情

00 · 需求描述 · 批量PDF保留排版翻译工具

外文资料成批翻译,
图表与文字仍有迹可循

外文论文、产品手册堆在文件夹里,逐段复制翻译很费时间;翻译完,多栏顺序乱了、公式与图表对不上,还要来回切换原文核查。遇到扫描PDF不能直接选中文字,处理起来更麻烦。

批量PDF保留排版翻译工具把多文件翻译、扫描页识别和双语对照放在同一界面,尽量保留文档原有版面,输出可直接阅读的译文与双语PDF。整批资料统一设置,处理结果按文件保存,剩余任务也能接着做。

保留排版与公式译文+双语对照扫描页OCR多文件/文件夹跳过已完成文件Windows 10 / 11

01 · 功能介绍和特点

从保留版面,到双语核对与批量归档

让PDF翻译结果更方便阅读、校对和整理。

保留PDF排版,阅读更连贯

翻译时尽量保留原文的多栏布局、公式、表格和图片位置。读论文、查手册时,更容易找到文字对应的图表,减少翻译完成后重新整理版面的工作。

译文与双语PDF,按需要输出

可同时生成译文和双语文件,也可只保留其中一种。双语支持原文与译文交替排页,并可选择左右对照,方便逐页核对术语、数据和上下文。

多文件与文件夹,集中批量翻译

支持加入多个PDF、多个文件夹和可直接访问的在线PDF链接。需要处理子文件夹时开启递归扫描,整批资料一次设置,减少逐个打开、设置和保存。

扫描页OCR,让图片型资料也能读

快速模式支持对纯扫描页识别文字后翻译,并可指定识别语言。适合扫描版说明书、历史资料等文档;先检查识别结果,清晰的印刷文字通常更适合处理。

多语言互译,覆盖常见阅读任务

提供英语、简体中文、繁体中文、日语、韩语、法语、德语等语言选项,也可填写语言代码。可按所选服务使用源语言自动识别,处理不同来源的外文资料。

多种翻译服务,按任务灵活选择

支持Google、Bing、DeepL、DeepSeek、OpenAI兼容接口、通义翻译、腾讯翻译等服务入口。根据已有账户、语言和文档特点选择,配置密钥后可测试连接。

本地翻译选项,适配不同使用条件

可选Argos离线翻译,或连接自己准备的Ollama、Xinference模型服务。便于按文档与设备条件安排翻译;软件登录与权限验证仍需要联网。

四种处理模式,先试译再批量

提供快速、极速、BabelDOC实验与精确模式。普通任务可从快速模式开始,文字型PDF可尝试极速模式,复杂版面可抽取少量页面比较其他模式的效果。

指定页码翻译,聚焦需要的章节

支持单页、连续范围和组合页码,例如1,3-5。先翻译摘要、关键章节或少量样本,确认效果后再处理全文,减少不需要的翻译请求。

自定义翻译要求,方便统一表达

支持提示词的模型服务可填写术语、语气和专业领域要求。处理同一项目的资料时,可使用一致的表达要求,减少后续逐篇调整译法的工作。

跳过已完成文件,方便继续处理

保留输出目录中的任务历史,使用相同输入和设置再次开始时,可跳过匹配的已完成本地文件。中断后继续处理剩余资料,减少重复翻译。

失败重试与结果报告,问题更好定位

可设置请求重试、文件重试与遇错继续,完成后生成CSV结果报告。根据报告查找失败原因,调整配置后通过重试失败入口继续处理。

保留目录层级,原件与结果不混乱

递归处理时可保留相对目录结构,输出遇到重名自动另存编号文件。原始文档不被覆盖,扫描文件夹时还能按设置跳过已生成的译文与双语PDF。

Word资料可转成PDF后翻译

安装并配置LibreOffice后,可加入DOC、DOCX文档,或在扫描文件夹时包含Word文件。最终生成译文与双语PDF,方便把不同来源的资料整理为统一阅读格式。

进度、超时与连接检查,处理更可控

可查看文件进度、耗时和错误提示,设置段落并发、网络代理与超时。资源检查帮助定位缺失文件,连接测试帮助确认服务配置,开始大批量任务前先排除常见问题。
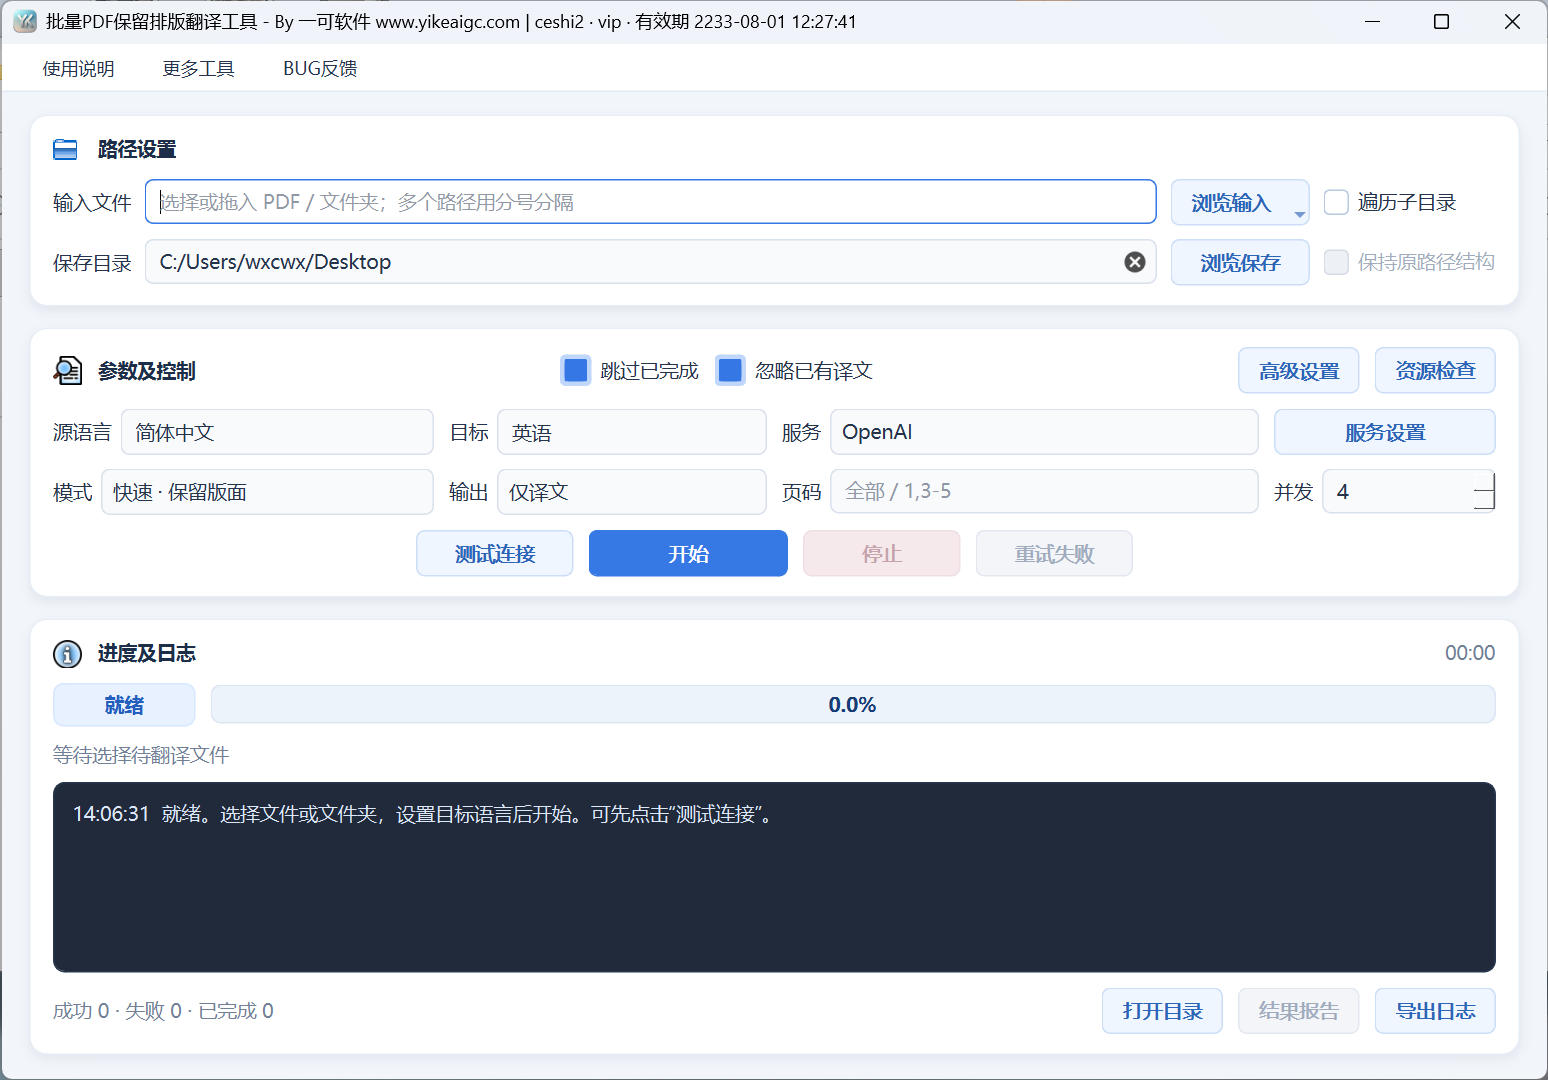
批量PDF保留排版翻译工具界面:添加PDF文件和文件夹,设置翻译模式、语言、服务、页码及双语输出并查看进度
文件导入、服务设置、翻译模式和结果进度,在同一界面完成。

02 · 应用场景

论文、说明书与项目资料,都有合适的用法

围绕阅读、校对和交付任务,选择需要的语言、范围与输出方式。

学生与研究人员|阅读外文论文

批量翻译同一课题的PDF论文,尽量保留公式、多栏与图表。使用双语对照核查专业术语,指定页码先阅读摘要和重点章节。

工程与技术人员|查阅产品手册

把设备说明书、技术规范和安装文档整理成中文PDF,配合原文对照查找参数与操作步骤,减少在不同窗口之间反复切换。

外贸与采购人员|整理海外产品资料

导入不同供应商的产品目录和使用说明,按文件夹保存翻译结果。结合图表和原文核对规格,再整理成团队可阅读的参考资料。

资料管理员|处理扫描版文献

对清晰的扫描PDF使用文字识别翻译,按语言和主题分批处理。通过结果报告检查异常文件,保留原件便于后续校对。

翻译与编辑人员|制作可校对的初稿

选择适合的服务并设置翻译要求,批量生成译文和双语版本。集中核对术语、数字和版面,把时间更多用于需要人工判断的内容。

项目团队|按目录交付阅读资料

保留项目资料的目录层级,统一输出PDF格式。通过CSV报告核对完成情况,失败项修正后单独重试,让整批资料交付更有条理。

03 · 使用说明

七步完成第一批PDF翻译

先用一个文件的一页确认配置与效果,再加入更多资料。

1

下载安装并登录,保留完整资源

在Windows 10/11电脑上下载软件,按安装包或压缩包内的说明打开并登录一可软件账号。请完整保留随包资源,不要只复制主程序。首次使用可先运行资源检查,确认本地文件齐全。

2

加入PDF,选择输入范围

选择一个或多个PDF,也可选择文件夹或填写可直接访问的PDF链接。需要继续增加来源时使用追加入口;文件夹默认只处理当前层级,需要子目录时勾选递归扫描。

3

选择语言和翻译服务

设置源语言、目标语言和翻译服务。需要密钥的服务填写自己的API Key、地址和模型;使用本地模型服务时先启动对应服务。用测试连接检查配置,测试会产生实际翻译请求。

4

选模式,先翻译少量页面

一般先用快速模式;纯文字PDF可尝试极速模式。扫描PDF请使用支持OCR的模式并确认识别语言。页码留空表示全文,也可填写1或1,3-5;页码必须在每个输入文件的实际范围内。

5

设置输出目录与对照方式

选择保存目录和译文+双语、仅译文或仅双语。双语默认交替排页,需要同屏比较可在高级设置中选择左右对照;递归处理文件夹时可勾选保留目录结构。

6

开始翻译,查看进度和提示

点击开始,观察当前文件、进度与日志。文档按顺序处理,并发数用于单个文件内的段落翻译,可先保持默认。需要中断时点击停止,已完成文件会保留,当前未完成文件之后可重新处理。

7

核对结果,继续处理剩余文件

用PDF阅读器检查译文、图表与术语,并打开CSV结果报告查看成功、失败和跳过项。修正网络、密钥或文档问题后,可重试失败;保持输入、设置与输出目录一致,并保留任务历史,可跳过已完成的本地文件。

按文档类型设置第一步

可以选中文字的PDF

先用快速模式,需要比较速度时再尝试极速模式。选取包含正文、表格和公式的样本页,检查排版后再开始批量任务。

无法选中文字的扫描PDF

使用快速模式并启用OCR,按文档内容选择识别语言。清晰度不足时先改善源文件,混合语言资料需设置相应OCR语言。

需要逐页校对的资料

输出选择译文+双语。普通阅读可用交替排页,大屏核对可选左右对照;保留原件便于检查关键术语与数字。

04 · 常见问题解答

排版、扫描件、翻译服务与续处理

点击问题展开答案,找到当前操作需要的说明。

PDF翻译后能完全保留原来的排版吗?

软件以保留原文版面为目标,尽量保留多栏、公式、表格与图片位置,但不能保证每份PDF完全一致。字体、原文质量、译文长度和复杂表格都可能影响效果。建议先选有代表性的页面试译,再检查整份结果。

支持扫描PDF和图片型PDF翻译吗?

支持。快速模式可对纯扫描页进行OCR文字识别后翻译,需启用OCR并选择合适的识别语言。极速模式适合可提取文字的PDF,不支持扫描页OCR。模糊、倾斜、手写内容和复杂表格可能需要先改善清晰度或人工校对。

PDF里的公式、图表和图片文字都会翻译吗?

工具尽量保留公式、图表与图片,公式通常作为原有内容保留。普通可提取文字会参与翻译,但图片内部文字不保证全部识别或替换,不能把扫描页OCR理解为所有插图文字都会翻译。关键图表、数字和公式请对照原文核查。

译文PDF和双语PDF有什么区别?

译文PDF用于直接阅读翻译结果,通常以-mono.pdf结尾;双语PDF保留原文和译文,通常以-dual.pdf结尾。可以同时输出,也可以只输出一种;遇到同名文件会自动另存编号文件。

双语对照能左右并排显示吗?

可以在高级设置中选择左右对照,将原文与译文放在同一宽页内,适合大屏阅读。默认交替排页更接近普通PDF的阅读方式。左右对照转换后,部分链接或批注可能不再保持原来的交互效果,需要时优先使用交替排页并保留原件。

四种翻译模式应该怎么选?

一般从快速模式开始;极速模式适合文字型PDF且不支持OCR;BabelDOC为实验模式;精确模式可用于比较复杂文档的处理效果。各模式对翻译服务和文档的兼容情况不同,名称不代表每份文件都会更好,先用少量页面比较即可。

支持批量翻译多个文件和子文件夹吗?

支持多个文件、多个文件夹混合输入,也可加入在线PDF链接。文件夹默认只扫描当前层级,勾选递归后处理子文件夹;需要延续目录结构时再开启保留目录。同一实际文件会避免重复加入。

在线PDF链接有什么要求?

需要可直接访问的HTTP或HTTPS PDF链接,普通文章页面、需要登录的网页或网盘分享页面通常不能直接作为PDF输入。网络链接会重新获取文件,不适用与本地文件相同的已完成历史跳过方式;需要稳定续处理时,可先保存为本地PDF。

可以只翻译PDF中的某几页吗?

可以。页码从1开始,留空翻译全文,可填写1,3-5或8-等范围,未选择的页面保留原文。同一批文件使用相同页码设置,页数不同的文件请分批处理,避免指定范围超出某个文件页数。

支持哪些语言和翻译服务?

提供中、英、日、韩、法、德、西班牙语等常见语言,并允许填写语言代码。内置24种服务入口,包括Google、Bing、DeepL、DeepSeek、OpenAI兼容接口、通义翻译、腾讯翻译及本地翻译选项。实际语言对与可用功能取决于所选服务和模式。

软件免费,翻译接口也免费吗?

软件当前免费使用,需要登录一可软件账号。需要API的翻译服务由用户自行准备账户、密钥和额度,费用以服务商为准,软件不附送商业接口额度。连接测试、重试和重新翻译也可能产生服务请求。

不想填写API Key,可以怎么用?

可按实际网络条件尝试无需在软件内填写密钥的Google或Bing服务,也可使用随完整资源包提供的Argos离线翻译。服务是否可达、支持哪些语言及使用限制,应以实际连接结果和服务方要求为准。

Argos离线翻译可以完全断网使用吗?

Argos的翻译过程可以在本地完成,但软件启动登录与权限验证仍需要联网,因此不能把整款软件理解为完全断网运行。使用Argos时需要明确选择源语言,不支持自动识别;可用语言对取决于随包模型,精确模式不支持该服务。

Ollama或Xinference模型需要自己准备吗?

需要。请先准备并启动自己的模型服务,再填写服务地址和模型名称。工具不会替你下载这些模型。速度、内存和显卡要求取决于所使用的模型及电脑配置,可先通过测试连接确认服务可用。

如何让专业术语和翻译语气更一致?

在支持提示词的模型服务中填写领域、术语译法和表达要求,并按软件说明保留必要的输入格式。同一批资料使用相同要求有助于统一表达,但仍需要人工核对。Google、Bing等不支持该选项的服务不会使用自定义提示词。

Word文档能直接加入吗,会输出DOCX吗?

可以加入DOC或DOCX,但需要先安装LibreOffice并在高级设置中配置位置。扫描文件夹时还需勾选包含Word文档。工具会把Word转换为PDF后翻译,最终输出PDF,不会生成翻译后的DOCX。

带打开密码的PDF可以处理吗?

可以在高级设置中填写正确的PDF打开密码。一次批量任务使用同一密码,不同密码的文件建议分批处理。软件不会破解未知密码,也不会覆盖原始文档;默认不记住密码,需要时可选择在当前Windows账户下加密保存。

停止或中断后,怎样继续翻译?

已完成的文件会保留,当前未完成文件可再次处理。重新使用相同本地输入、翻译设置和输出目录,保留任务历史并勾选跳过已完成,即可继续处理剩余文件。它按匹配的完成记录判断,不是仅看到同名PDF就跳过,也不保证从中断段落原位恢复。

更换语言、模型或输出方式后会重新翻译吗?

修改影响任务结果的设置后,原有完成记录可能不再匹配,因此可能重新处理。若要强制重新翻译,应取消跳过已完成,并按需在高级设置启用忽略缓存。重新请求服务可能增加耗时与接口用量。

一个文件失败,会影响后面的文件吗?

开启遇错继续后,普通单文件失败可以记录后继续,并按设置重试。初始化失败、手动停止或单文件超时等情况会停止整批任务。请查看提示与CSV报告,排除问题后重试;达到单文件时限时,已完成文件仍会保留。

重试失败和CSV报告怎么使用?

每批任务都会生成CSV报告,记录文件路径、结果、输出位置、耗时和错误。当前运行中的重试失败按钮根据最近一次报告选取失败项;调整服务或网络配置后可再次处理。中断时尚未写入失败记录的文件,可重新开始原任务继续处理。

并发数越高就一定越快吗?

并发数用于同一文件内的段落翻译,多个文档仍按顺序处理。提高并发可能受到接口速率、网络和电脑性能限制,过高时反而可能触发限流或重试。建议先使用默认值,再根据实际服务额度与运行情况调整。

输出会覆盖原PDF或之前的译文吗?

不会覆盖原件或已有输出,同名结果会自动编号另存。文件夹扫描可跳过已生成的-mono、-dual文件,减少重复处理;直接手动选择这些文件时仍会作为输入。续处理还需要保留输出目录内的任务历史。

资源检查通过,为什么翻译还是失败?

资源检查主要检查本地文件是否完整,不代表网络、API Key、服务额度或模型名称正确。可再用测试连接确认服务配置,并检查文件是否损坏、密码与页码是否正确。首次加载或保存较大PDF时进度可能暂时不变,可结合日志判断。

需要安装Python吗,支持哪些Windows系统?

支持Windows 10/11,使用完整发行包无需自行安装Python,精确模式所需的随包环境也应完整保留。Word输入额外需要LibreOffice;外部本地模型服务需自行准备。大文件和本地大模型需要相应的内存与磁盘空间。

05 · 下载地址

下载批量PDF保留排版翻译工具

支持Windows 10/11 · 版本1.0.0 · 软件免费

把成批外文PDF变成更容易阅读和核对的资料。先从一份论文或一页说明书开始,确认效果后再批量处理。

需要登录一可软件账号并联网验证;商业翻译服务的密钥与额度需自行准备。完整保留随包资源,Word输入需另行安装LibreOffice,本地模型服务按需自行配置。
查看更多办公处理工具