功能关键词:多文件PDF合并、目录批量合并、页面范围、手动排序。
工具概述
批量PDF合并工具有两个选项卡,“批量合并”按照规则收集并排序PDF文件,然后合并为一个文件,而“直接合并”则按照列表的手动顺序合并为指定名称的PDF。适合按顺序汇总分散的章节、扫描件、参考文件。
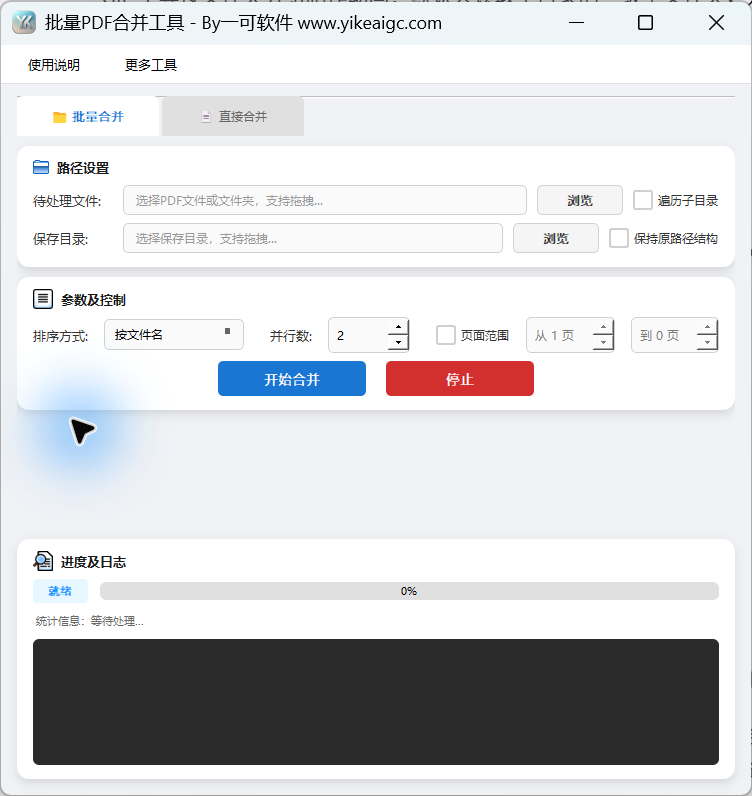
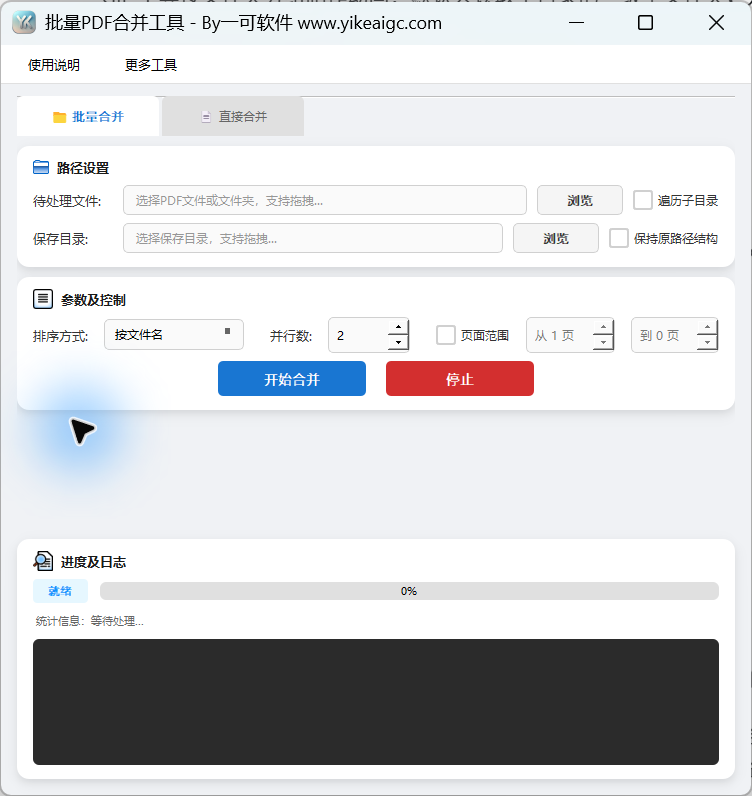
页面提供文件或目录来源、子目录扫描、三种排序方式、各来源使用的页面范围、带拖动排序功能的直接合并列表;两种模式共享底部的进度、统计和日志。
工具截图
主要功能
- 从多个PDF文件或目录中收集文件,根据需要递归扫描子目录,最终合并为一个PDF。
- 批量模式按文件名自然顺序、修改时间升序或文件大小升序排序。
- 为各来源指定通用的起始页和结束页,或合并所有页面。
- 直接模式可累积添加PDF文件、拖动排序、上下移动、选择完整的输出文件名。
- 结果名称重复时,会自动附加_1、_2等;此外,批量模式可根据排序后第一个来源的位置安排输出层级。
- 日志分别记录读取失败、无效页码、来源添加、输出写入,并统计文件数、页数和大小。
使用前的准备
请准备可读取的.pdf文件或包含PDF文件的文件夹。页面没有文档转换、图片导入、OCR、用于打开文档的密码输入框;读取损坏的来源、受保护的来源及其他来源失败时,请查看日志。
批量合并需要保存目录,目录不存在时,可在正式开始时尝试创建;直接合并需要包含名称的PDF保存路径。两种模式的输出输入框用途不同。
批量模式会将收集到的所有文件合并为一个结果,并非每个子目录一个。需要手动确定顺序时,请切换到直接合并页面。
扫描不会自动排除输出目录,后续运行时可能再次收集旧的PDF文件,因此建议将保存位置与来源范围分开;多个来源目录与结构选项配合使用时,也请注意相对路径的基准。
详细操作步骤
1. 在批量合并页面选择来源和保存目录
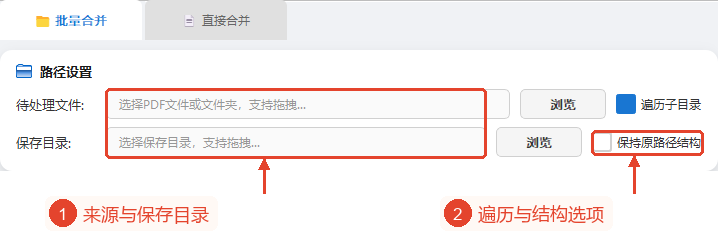
默认选项卡为“批量合并”。请点击“路径设置”中“待处理文件”的“浏览”,先选择文件或文件夹类型,再选择多个PDF文件或一个目录;也可以将文件或文件夹拖入输入框。单个路径可直接输入,但多个路径不支持解析手动输入的分号。
浏览或拖放会记录内部来源列表,并显示路径或选择数量;之后仅修改框内文本不会替换现有列表,因此要更改来源,请重新浏览或重新拖入项目。批量收集不会去重,来源目录重复时,可能重复添加同一个PDF。
请点击第二行“保存目录”的“浏览”选择输出文件夹,或拖入目录;拖入文件时,将使用其父目录。这不是完整的PDF文件路径。
需要来源子目录中的PDF文件时,请勾选“扫描子目录”。“保留原路径结构”仅在启用扫描时可用,但此工具只写入一个合并文件,实际上并非分别重建各来源,而是将其放在排序后第一个PDF相对于基准目录的位置。
有多个来源目录时,最后扫描的目录将用作基准目录,第一个PDF位于其他根目录时,相对路径可能包含..,并写入预期目录之外。仅建议对单个主目录使用结构选项;来源混合时可禁用。此图中仅勾选了扫描,未选择资料。
2. 设置批量排序和通用页面范围,然后确认运行控件
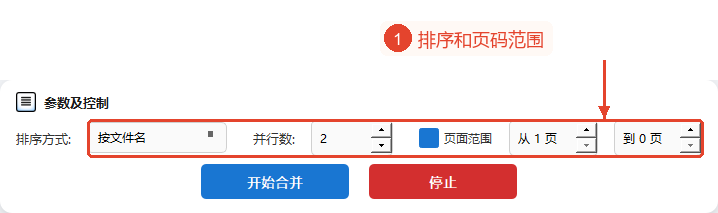
请在“参数与控制”的“排序方式”中选择按文件名、按修改时间、按文件大小排序。文件名使用自然排序,带编号的章节按1、2、10的顺序排列;修改时间从旧到新,文件大小从小到大,没有升序和降序切换。
仅从各PDF中提取部分页面时,勾选“页面范围”即可启用起始和结束输入框。起始页范围为1至9999,结束页为0至9999,结束页的0表示直到该来源的最后一页;例如,1至3包含第1、2、3页。此范围分别应用于各来源,不应用于合并后的整体页码。
超过来源页数的结束页会被限制为实际最后一页;起始页不小于有效结束页时,该来源会被记录为无效范围并跳过。截图中仅勾选了范围,保留了从第1页到第0页的两个默认值。
页面上“并行数”的范围为1至8,默认为2;当前实现仅将值赋给参数,不启动并行任务循环,实际上会逐个向同一合并处理中添加文件,因此请勿期待增大数值就一定会加快速度。
正式确认后,请点击此页面的“开始合并”。单个目录的结果名称为目录名_merged.pdf,单个文件为基本名_merged.pdf,多个文件或来源为merged_output.pdf;已存在同名文件时会附加编号。本文未点击。
3. 需要手动设置顺序时切换到直接合并,管理PDF列表
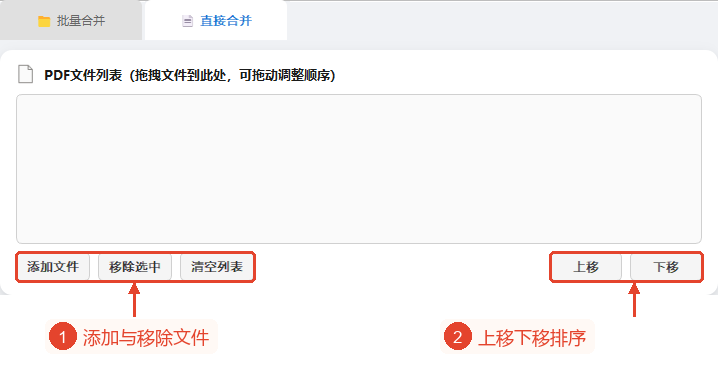
请点击顶部的“直接合并”,进入“PDF文件列表”区域。请点击“添加文件”选择PDF文件,或将多个PDF文件拖入列表;后续添加会累积,列表中已有的相同路径不会再次添加。
列表中的文件名用于显示,鼠标悬停时显示完整路径。选择项目后,通过“上移”和“下移”调整当前项目,或按照界面提示拖动列表项目更改顺序,正式合并时将使用当前从上到下的顺序。
“删除选中项”仅从当前列表中删除项目,可多选;“清空列表”会清空当前合并列表,不会删除磁盘上的PDF文件。页面没有内容预览、缩略图、逐文件页码编辑。
直接合并不使用批量页面的排序、扫描、结构、并行数、页面范围设置;此页面按列表顺序导入完整的来源PDF文件。仅需要各文件中的部分页面时,请使用批量模式的对应选项。
截图仅切换到了空列表,未点击添加并选择测试用PDF文件,也未使用占位资料伪造列表状态。
4. 设置直接合并的完整保存路径,根据需要开始或停止
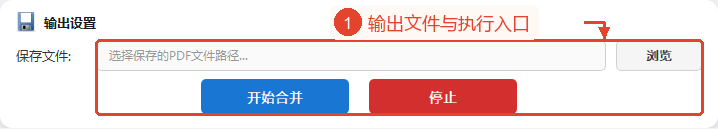
请在直接页面点击“输出设置”中“保存文件”的“浏览”,在保存对话框中选择目录并输入PDF文件名;确认后也只是填入路径,实际写入仍由“开始合并”执行。也可输入完整路径,没有.pdf时会在开始前添加。
将目录拖入此框时,会自动使用该目录内的merged_output.pdf;拖入文件时,会使用该文件的路径。已存在同名文件时,为避免覆盖原文件,仍会附加_1、_2,输出的父目录不存在时,可尝试创建。
正式确认列表顺序和保存名称后,请点击此页面的“开始合并”。程序会重新检查权限,按当前列表顺序添加完整的PDF文件,任务期间两个选项卡的开始按钮都会被禁用。
“停止”会为当前合并处理设置停止标志,此标志在来源之间检查,不会立即中断当前正在读取或添加的大型PDF。在最终写入开始前停止时,不会写入整个当前合并结果;如果文件写入阶段已经开始,停止也不会撤销已写入的内容。
程序既没有暂停和恢复功能,也不单独保存中间片段,运行时界面可能暂时繁忙,请等待任务返回后再关闭。图中的保存框和列表均为空,未点击浏览保存对话框,也未点击执行合并。
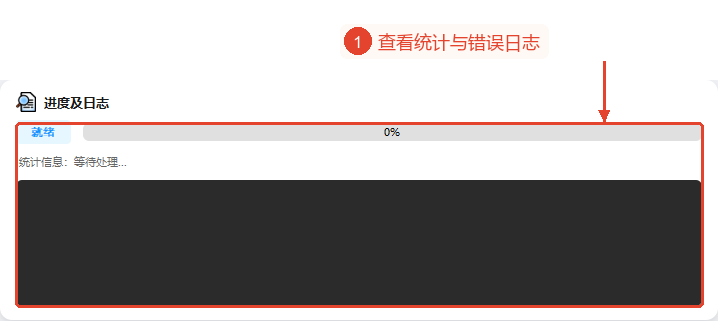
5. 查看共享进度和统计,从所选路径获取PDF
两个选项卡共享底部的“进度与日志”。来源成功添加后会记录文件名和页数,失败时记录异常,无效页面范围标记为跳过;有错误的来源可能从结果中排除,其余来源继续处理。
统计包括成功数、失败数、添加页数、来源大小、实际输出大小。“成功”在来源添加时计数,最终写入失败或被停止时,这些成功数不代表完整的PDF一定已保存。
完成回调会将进度设置为100%,并将状态显示为完成,即使没有文件、任务被停止、有错误,也可能显示此状态。因此,请检查日志中“合并完成”的写入记录和错误信息,不要仅凭100%就判断所有来源都包含在完成的文件中。
页面没有用于打开目录、下载、复制完成的文件、预览结果的按钮。请使用批量保存目录和自动名称,或直接页面中选择的完整路径,在文件管理器中查找PDF;启用结构选项时,也请按照所述的第一个来源的相对位置查找。
截图仍处于准备就绪0%和等待处理状态,没有合并完成日志。本次使用快速制作模式,未加载或上传PDF文件,未执行合并,也未验证输出。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 批量来源 | 多个文件或目录,可使用递归处理,不去重。 | 请避免来源重复,更改来源请使用浏览或拖入项目。 |
| 保存目录/保存文件 | 批量模式使用目录,而直接模式使用完整的PDF路径。 | 两个页面的路径不会相互替代。 |
| 排序方式 | 文件名自然顺序、修改时间升序、大小升序。 | 直接模式遵循列表顺序,不读取此设置。 |
| 页面范围 | 起始1~9999,结束0~9999,0表示最后一页。 | 独立应用于各来源,直接模式不使用。 |
| 并行数 | 1~8,默认2。 | 目前未接入实际的并行循环。 |
| 保留结构 | 依赖扫描,仅决定一个最终结果的位置。 | 混合多个来源目录时建议禁用。 |
| 直接列表排序 | 拖动当前项目,或上下移动。 | 始终遵循从上到下的顺序,合并完整的PDF文件。 |
| 停止 | 在来源之间检查标志,可在写入前丢弃当前结果。 | 不是暂停,不会撤销已进入写入阶段的内容。 |
结果与保存
批量模式将收集到的所有来源合并为一个PDF:单个目录为目录名_merged.pdf,单个文件为基本名_merged.pdf,多个来源为merged_output.pdf;直接模式使用所选的保存文件名。名称重复时会附加_1、_2。
保留结构仅影响这一个结果的保存位置,按照排序后第一个PDF相对于基准目录的位置放置;混合多个根目录时可能产生..路径,因此请按照教程说明禁用,或将来源限制为单个目录。
范围从各PDF中提取页面,而直接模式按照列表添加完整文件;工具没有PDF阅读、OCR、文档转PDF、用于打开文档的密码输入。失败的来源可能被跳过,输出不一定包含列表中的所有内容。
日志显示合并写入信息后,请从实际保存位置获取文件;成功统计仅为来源添加次数,还需要结合最终大小和写入日志检查。本次未生成、打开或验证合并后的PDF。
常见问题与使用建议
1. 批量模式会为每个子文件夹生成一个文件吗?
不会,收集到的所有PDF文件会合并为一个,目录扫描只是扩大来源范围。
2. 批量输入支持手动输入以分号分隔的多个路径吗?
没有分号解析,多个项目通过浏览多选或拖动添加到内部列表。
3. 为什么修改路径文本后仍可能使用旧来源?
现有内部来源列表优先,仅修改显示文本不会替换,因此请重新浏览或重新拖入项目。
4. 按文件名排序时,10会在2前面吗?
使用自然排序,数字部分按数值比较,通常按1、2、10的顺序排列。
5. 到第0页是什么意思?
表示直到各来源PDF的最后一页,并非只提取第0页。
6. 页面范围是针对最终的PDF设置的吗?
从各来源分别提取相同区间,然后按顺序添加;直接模式不使用此参数。
7. 并行数越高,处理速度就一定越快吗?
当前代码没有实际的并行合并循环,此控件不会带来相应的加速。
8. 直接模式如何更改顺序?
请在列表中拖动,或选择当前项目后上下移动;将使用当前从上到下的顺序。
9. 已有的同名输出会被直接覆盖吗?
会自动附加_1、_2等编号,请查找实际输出名称。
10. 在100%时完成能证明所有PDF文件都已合并吗?
不能,100%在结束时统一设置,失败和停止也需要查看日志;成功计数在最终写入之前进行。