功能关键词:指定的PDF页面转图片、批量提取PDF页面、导出PDF的最后一页、DPI清晰度、图片命名。
工具介绍
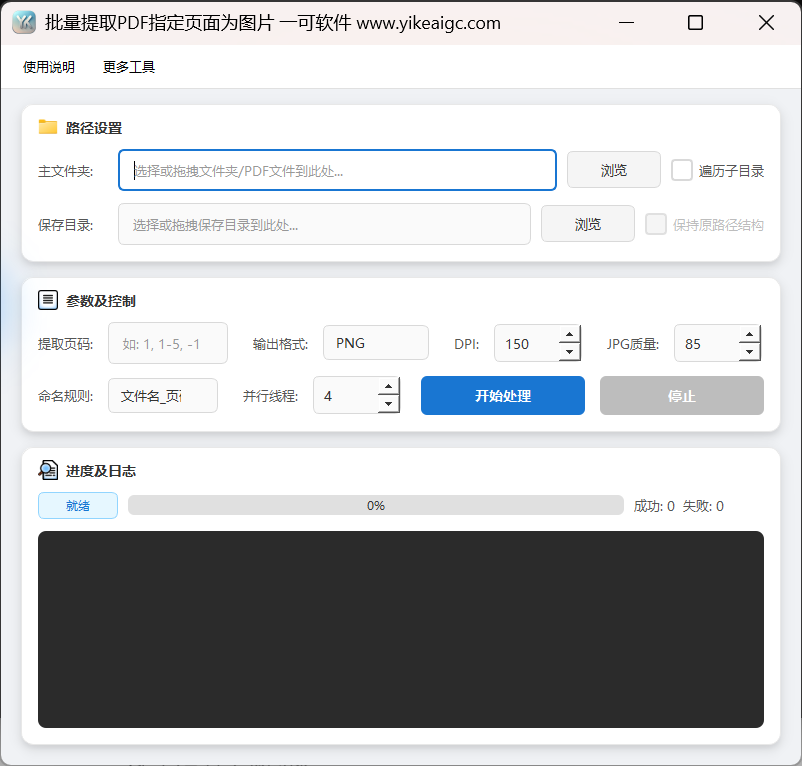
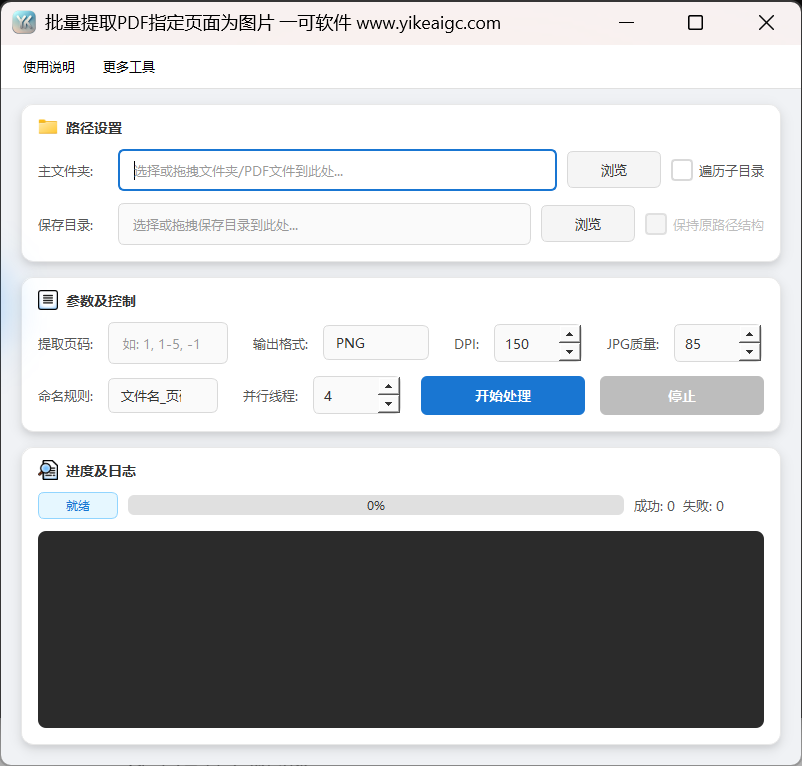
“批量将指定的PDF页面提取为图片”用于按照统一的页码规则,渲染文件夹内PDF文件中的指定页面并保存图片。适合批量提取封面、最后一页或固定的一组页面,此页面提供PNG、JPG、WEBP格式选项。
可以设置单页、多个页码、升序范围、从末尾计数的页面,调整DPI、JPG画质、文件命名、并行线程,并根据需要遍历子目录并保留相对结构。导出的是整页渲染后的图片,而不是单独提取PDF内的嵌入照片。
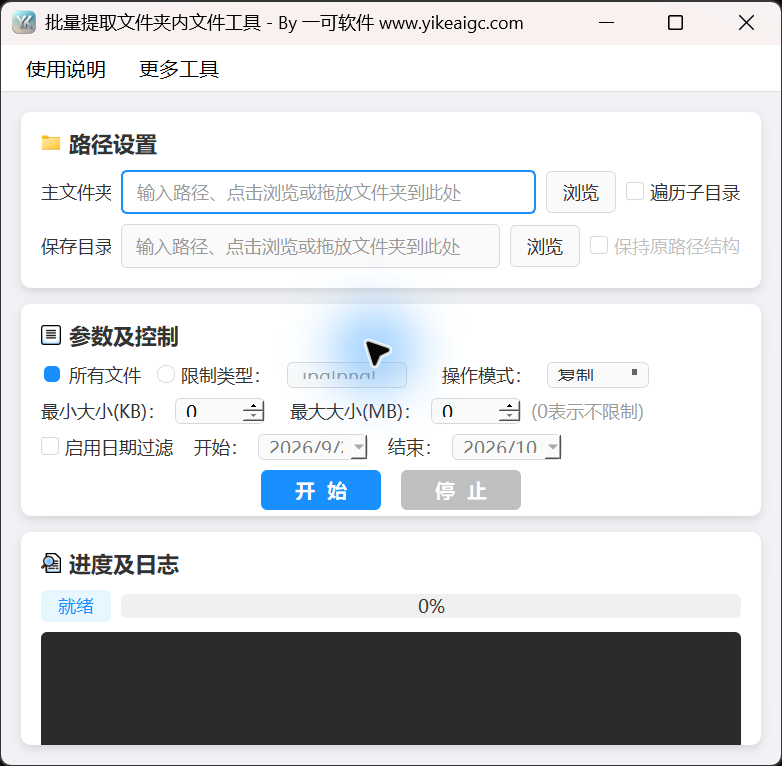
工具截图
主要功能
- 从主文件夹收集PDF文件,并根据需要包含所有子目录。
- 使用从1开始的页码、多个页码、升序范围,批量提取整页。
- 支持表示最后一页的-1和表示倒数第2页的-2,按照各PDF自身的总页数以相同规则计算。
- 按照DPI渲染页面,提供PNG/JPG/WEBP输出选项和JPG画质设置。
- 提供文件名_页码、页码_文件名、仅文件名这3种命名规则,输出目标已存在时尝试添加编号。
- 可以保留相对目录结构,使用1~16个线程以PDF为单位并行处理。
- 通过日志查看各PDF的输出页面、输出文件名或失败原因,并记住上次的路径和参数。
使用前的准备
准备包含PDF文件的主文件夹和用于保存图片的文件夹。此页面的输入以文件夹为单位工作,不提供多个源目录的列表。
准备本次批量提取的页码规则;页码不能为空,要生成相应输出,每个PDF必须至少匹配1页。
如果需要遍历子目录并保留输出层级,请先勾选“遍历子目录”,再勾选“保留原路径结构”。
详细操作步骤
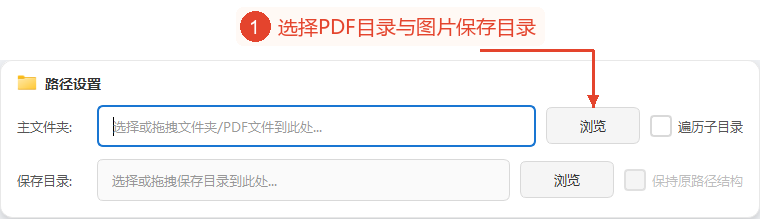
1. 选择PDF主文件夹和图片保存目录
在“路径设置”的第1行,点击“主文件夹”右侧的“浏览”,选择包含PDF文件的文件夹;在第2行的“保存目录”中,点击“浏览”选择图片输出位置。也可以将文件夹拖入对应的框中。
主文件夹框中虽然显示可以拖入PDF,但拖入PDF后,输入会被设置为该文件所在的目录,实际上并非只添加这1个文件,而是扫描该目录内目标范围中的所有PDF文件。一次拖入多个项目时也只使用第1个,不支持用分号连接多个目录。
默认只收集主文件夹当前层级中的PDF文件。需要子文件夹时,勾选“遍历子目录”,并根据需要勾选“保留原路径结构”;取消勾选遍历时,也会取消勾选保留结构。为便于之后查找,建议使用单独的图片目录作为输出位置。
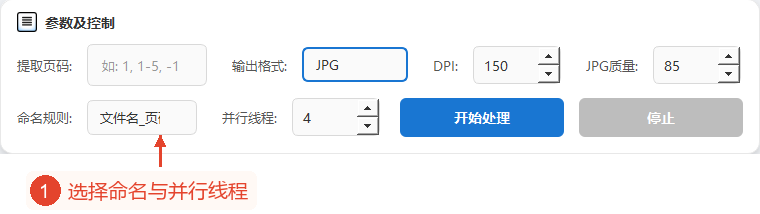
2. 输入要提取的页码,选择格式、DPI、JPG画质
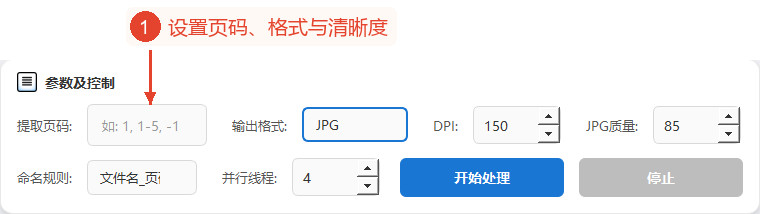
在“要提取的页码”中输入从1开始的页码;例如,1表示第一页,1,3,5表示多个页面,1-5表示第1~5页,-1表示最后一页,-2表示倒数第2页。这些可以像1,3-5,-1这样混合使用,每个PDF都按照自身的页数进行解析。
重复页面会被去重,最终输出按原PDF页码的升序排列,不会按照输入顺序排序。升序范围使用起始页-结束页,不支持5-1这样的倒序范围或-3--1这样的负数范围;页码0、无法识别的部分、超出范围的页面会被忽略。如果PDF中没有有效页面,日志中会显示无效或超出范围的消息。
在“输出格式”中选择PNG、JPG或页面提供的WEBP。默认为PNG;选择JPG后,“JPG画质”变为可用,范围为1~100,默认为85,仅影响保存时的JPG压缩。WEBP没有单独的转码分支,如果保存接口提示不支持此格式,可以切换为PNG或JPG。
“DPI”可指定为72~600,默认为150,按DPI/72的比例渲染,改变输出图片的像素尺寸;提高数值也会增加内存占用和文件大小。画质参数不能代替用于增加像素的DPI。
3. 选择图片命名规则和并行线程
“命名规则”默认为文件名_页码,生成原文件名_p1形式的名称;页码_文件名生成p1_原文件名。选择“仅文件名”时,仅在输出图片为1张时省略页码,输出图片为多张时,仍会自动添加_p页码以作区分。
图片扩展名由所选格式决定。如果目录内已存在相同名称,工具会尝试添加_1这样的编号;不同来源的PDF文件具有相同的基本文件名,并同时输出到扁平目录时,仍可能发生名称冲突,建议保留目录结构、使用不同的源名称或分批保存。
“并行线程”的范围为1~16,默认为4,以PDF文件为单位分配并行任务,每个PDF内所选的页面按顺序渲染。DPI较高或PDF较大时,可以适当减少线程数,以免同时占用大量内存。
4. 开始提取,使用进度和日志确认输出
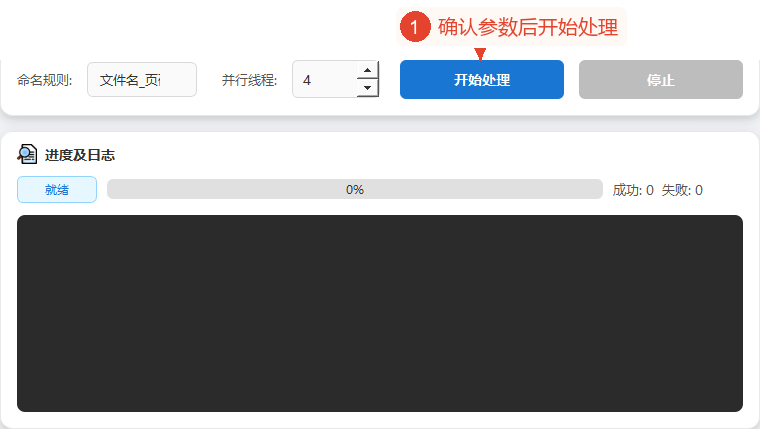
确认实际目录、页码、格式和参数后,点击“开始处理”。软件会检查登录权限、路径和页码不为空,收集PDF文件后,开始以文件为单位并行渲染。
“进度和日志”中显示整体进度和成功/失败数量。进度按照任务已回收的PDF文件数更新,成功主要按已保存的页面统计,失败可能来自单个页面,也可能来自无法打开或没有有效页面的整个PDF,因此不能简单地将这两个数量视为成功/失败的PDF文件数。
需要停止时,点击“停止”,等待正在运行的任务结束。已经开始处理单个PDF的线程不会逐页检查停止,可能继续导出该PDF的页面;已写入的图片会保留,停止后统计可能不完整,最终状态也可能显示为完成。
使用文件管理器查看所输入保存目录内的输出。日志中显示原PDF、页码、输出文件名、失败原因,最多保留最新的200条;此页面没有用于打开输出目录、预览结果、下载或自动CSV报告的控件。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 要提取的页码 | 单页、多页、升序范围、从末尾计数的负数页面 | 例如,1,3-5,-1;不支持负数范围。 |
| 输出格式 | PNG、JPG、WEBP | 默认为PNG;有关格式支持的问题,请查看日志。 |
| DPI | 72—600,默认150 | 改变渲染的像素尺寸,数值越高,使用的资源越多。 |
| JPG画质 | 1—100,默认85 | 仅在JPG中可用,不控制PNG或WEBP。 |
| 命名规则 | 文件名_页码、页码_文件名、仅文件名 | 多页时,即使选择“仅文件名”也会添加页码。 |
| 并行线程 | 1—16,默认4 | 使用PDF文件作为并行任务,DPI较高时可以减少。 |
| 遍历子目录 | 包含所有层级子目录内的PDF文件 | 默认关闭。 |
| 保留原路径结构 | 在保存目录内复制源的相对层级 | 仅在启用遍历时可用。 |
结果与保存
图片以当前格式写入指定的保存目录,每个有效的所选页面对应一张渲染图片。启用保留结构时,按照PDF所在目录相对于主文件夹的相对路径创建层级;不会为每个PDF自动创建同名的额外子目录。
名称中包含的页码是原PDF内的实际页码,即使使用-1,文件名中也会包含实际的最后一页页码。重复页面只输出1次,输出顺序为源页码的升序。
对于同名文件,工具会尝试添加编号,检查现有文件和并行保存之间没有统一锁;将多个同名PDF文件输出到扁平目录时,需要注意源名称冲突。停止时已写入的文件不会回滚,界面统计可能不包含所有正在运行的输出。
PNG及其他格式会传递给页面保存接口,JPG会另行传递画质参数;能否写入WEBP取决于当前保存接口的支持和日志消息。此工具没有PDF密码输入框,无法直接打开的加密或异常PDF文件,会在日志中显示打开失败。
常见问题和使用建议
1. 为什么拖入一个PDF后,目录内的其他PDF文件也会被处理?
输入会转换为该PDF所在的目录,实际任务按目录收集。
2. 如何提取每个PDF的最后一页?
在“要提取的页码”中输入-1,软件会按照每个PDF自身的总页数计算。
3. 可以输入-3--1提取最后3页吗?
当前解析不支持负数范围,可以分别输入-3,-2,-1。
4. 输入5,1时,会先输出第5页吗?
不会,解析时会对页面去重,并按原页码升序输出。
5. 有几个页码超出范围时,整个批次会停止吗?
超出范围的项目会被忽略;如果PDF中完全没有有效页面,会记录失败,其他文件仍会按照各自的任务继续处理。
6. 为什么PNG不能使用JPG画质?
画质只传递给JPG保存分支,PNG和WEBP不受此值控制。
7. DPI只改变打印标签吗?
不是,它决定页面的渲染比例,并改变输出的像素尺寸。
8. 使用“仅文件名”导出的多个页面会互相覆盖吗?
多页时仍会添加_p页码;对于同名的不同PDF文件同时输出到扁平目录所产生的冲突,仍需注意。
9. WEBP提示不支持格式时该怎么办?
此页面没有额外的WEBP转码分支,可以切换为PNG或JPG并查看具体日志。
10. 为什么停止后仍在写入图片?
停止只会取消尚未开始的任务,当前正在处理的整个PDF可能继续处理页面,需要等待线程结束。