功能关键词:批量统计中文字符、英文单词数、文档字符数、导出Excel报告、多格式文档统计。
工具介绍
文档批量字符数统计工具读取指定文件夹内文档中可提取的文本,计算各文档的中文字符、英文单词、数字、标点符号、总字符数,并汇总文件数和平均中文字符数。适合批量了解稿件、教材、文档内容的规模。
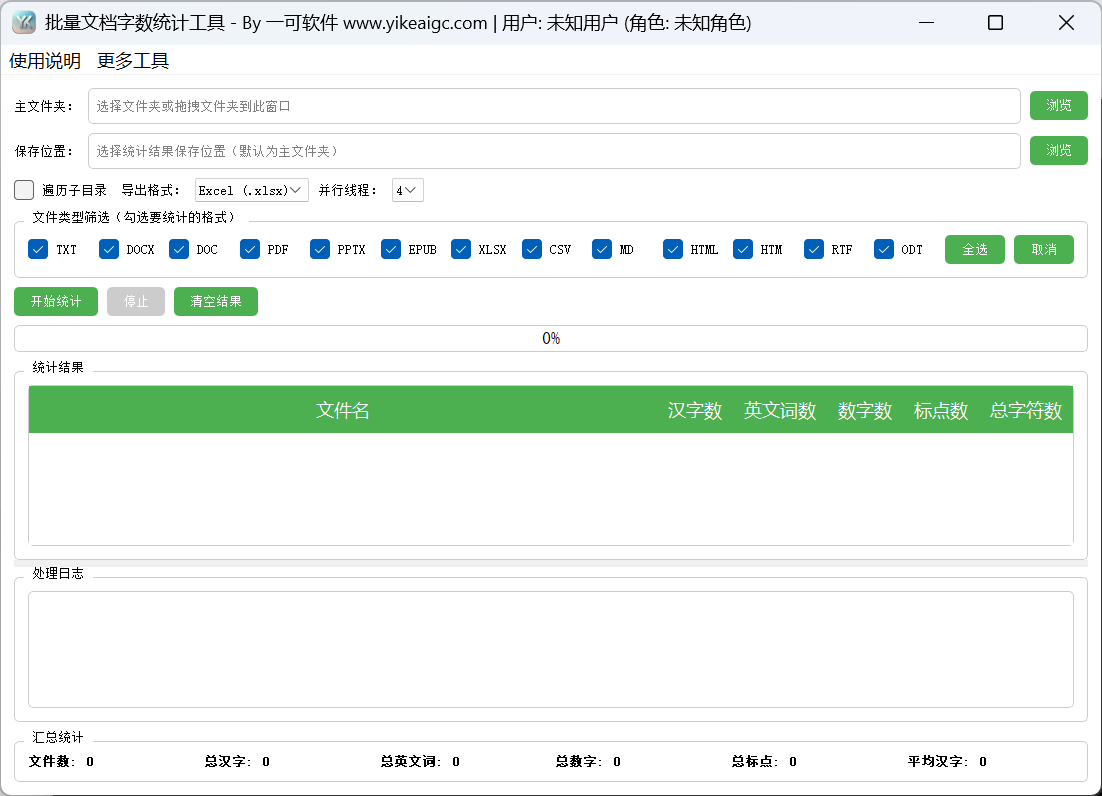
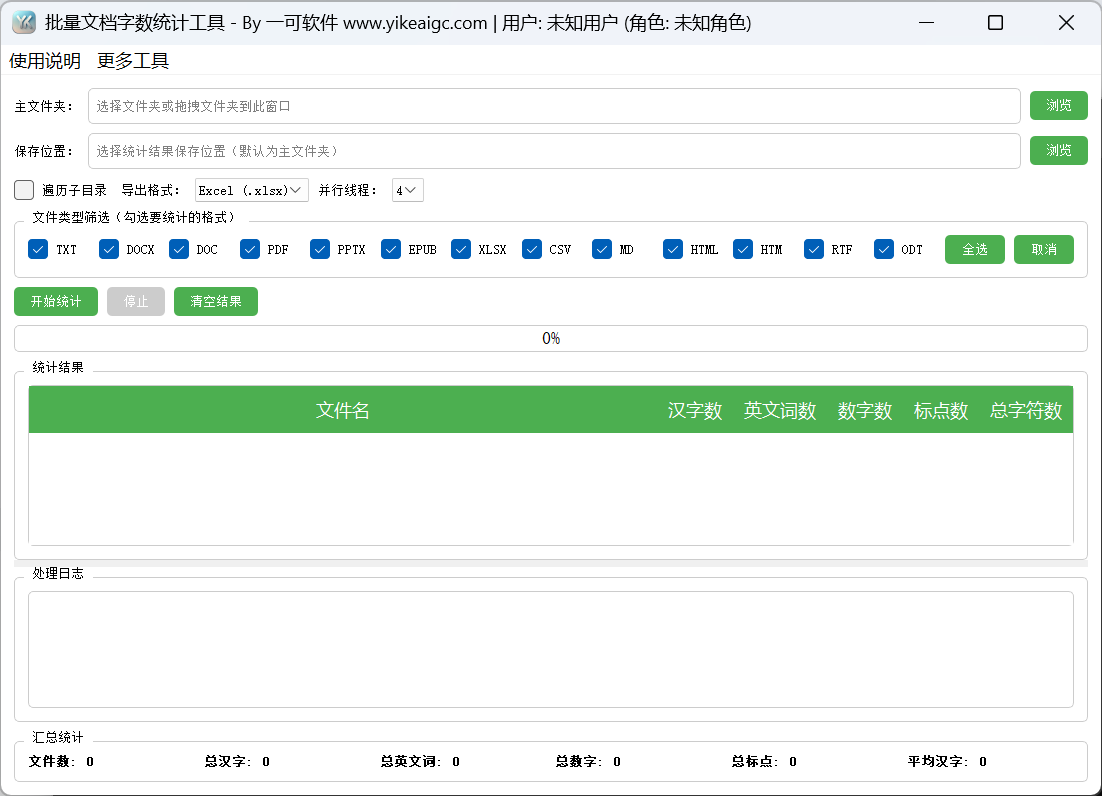
本页面提供13种格式的筛选、子目录遍历、并行线程,以及Excel、CSV、TXT的自动导出。数值使用工具自身的字符匹配标准,与Word或出版排版软件的综合字数并不等同。
工具截图
主要功能
- 统计单个来源文件夹的当前层级,或其所有子目录内的候选文档。
- 按TXT、DOCX、DOC、PDF、PPTX、EPUB、XLSX、CSV、MD、HTML、HTM、RTF、ODT筛选,可选择全选,或取消选择后逐项勾选。
- 显示各文件的中文字符数、连续英文字母串数、连续数字串数、指定标点符号数、总字符数。
- 汇总成功创建统计记录的文件数、各类别的数量、整数形式的平均中文字符数。
- 提供2、4、6或8线程的并行读取,以及进度和日志显示。
- 存在有效统计记录时,自动保存所选格式的报告,Excel和CSV包含完整来源路径,TXT包含各文件的文字说明。
使用前准备
请准备一个有效的主文件夹;可通过浏览选择,或拖入整个文件夹来指定;本工具不接受直接拖入单个文件作为唯一来源。
请至少勾选一种文件类型。读取DOC可能需要antiword或textract等组件;RTF和ODT需要相应的可选支持,缺失的组件会显示在日志中。
请准备一个可写且已存在的报告保存位置。留空时默认使用主文件夹;建议单独保存报告,以免下次统计时将旧报告包含在来源中。
详细操作步骤
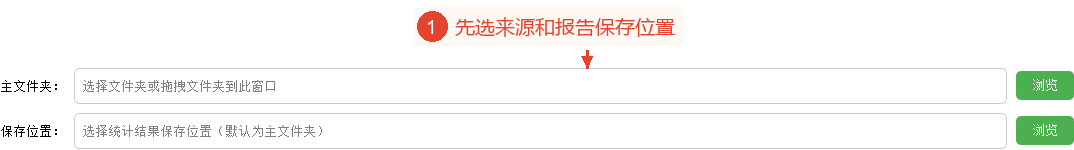
1. 选择主文件夹和报告保存位置
请点击“主文件夹”行的“浏览”选择要统计的目录,或将文件夹拖入窗口;拖放仅获取第一个文件夹路径,不会作为多来源列表处理。输入路径时,必须指向目录。
请点击“保存位置”行的“浏览”,选择现有的输出目录。此保存位置用于统计报告,统计处理不会改写来源文档。保存位置留空时使用主文件夹;输入不存在的目录时,保存逻辑会回退到主文件夹的父目录,不会根据该输入自动创建目录。
请选择单独的保存位置,并记住路径。程序会记住最后浏览的目录;尤其在之后切换批次时,请在开始前确认当前的来源栏和保存栏。
2. 选择扫描范围、文档类型、导出格式和线程
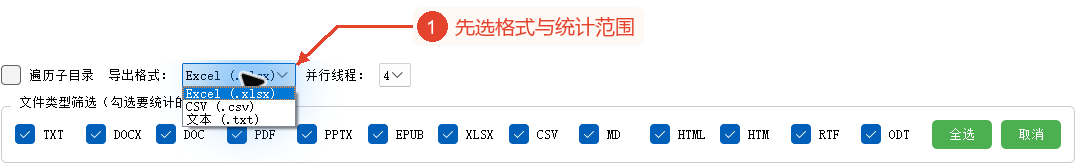
勾选“遍历子目录”时,将包含子目录内的所有文档,取消勾选时,仅处理主目录的当前层级。扫描不会自动排除保存目录或旧统计报告,建议将报告保存在来源目录之外。
“文件类型筛选”的全部13种类型默认均已勾选。如果只统计特定格式,请点击右侧的“取消选择”取消全部选择,然后逐项勾选;“全选”会恢复所有显示的格式。此处的“取消选择”仅更改格式选择,不会取消正在运行的任务。
展开“导出格式”,选择Excel(.xlsx)、CSV(.csv)或文本(.txt);默认为Excel。存在统计记录时,会在结束处理期间自动保存一份所选格式的报告,无需点击单独的保存按钮。
“并行线程”提供2、4、6、8,默认为4。这控制同时读取的文档数,不会更改字符数统计规则;磁盘读取负载较高时,可适当减少。请在运行前完成导出和保存设置,以免处理期间的更改影响最终报告。
3. 实际开始使用后查看进度,并按需停止
实际准备好来源、保存位置和类型后,请点击“开始统计”。软件首先重新确认登录凭据和使用权限,然后收集候选文件并读取文本;开始时,会清空上一次界面的表格、日志和统计数据。
需要结束处理时,请点击“停止”。尚未开始的任务可以取消,但已经在读取的任务可能会先完成,不应将停止期间按钮的变化理解为所有线程均已立即结束;已经收集的结果可能会在结束处理期间自动导出。
进度根据已收集结果的候选任务数计算,读取失败也会推进进度。停止后,程序也可能写入通用的“处理完成”日志项,因此判断范围时,需要结合错误、提取失败、停止记录和最终文件数进行考虑。
“清空结果”会清空表格、日志、进度和汇总,不会删除磁盘上的报告,也不能代替停止任务。需要保留统计记录时,请先确认自动保存路径,不要将运行期间的清空视为取消。本教程未开始统计,也未读取文档。
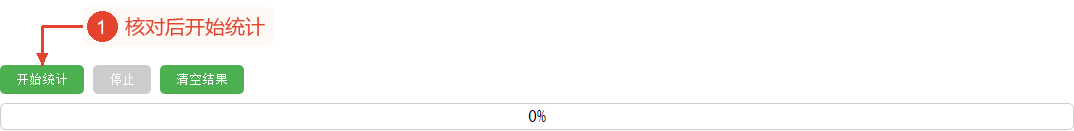
4. 按统计标准阅读结果,并检查日志和自动报告
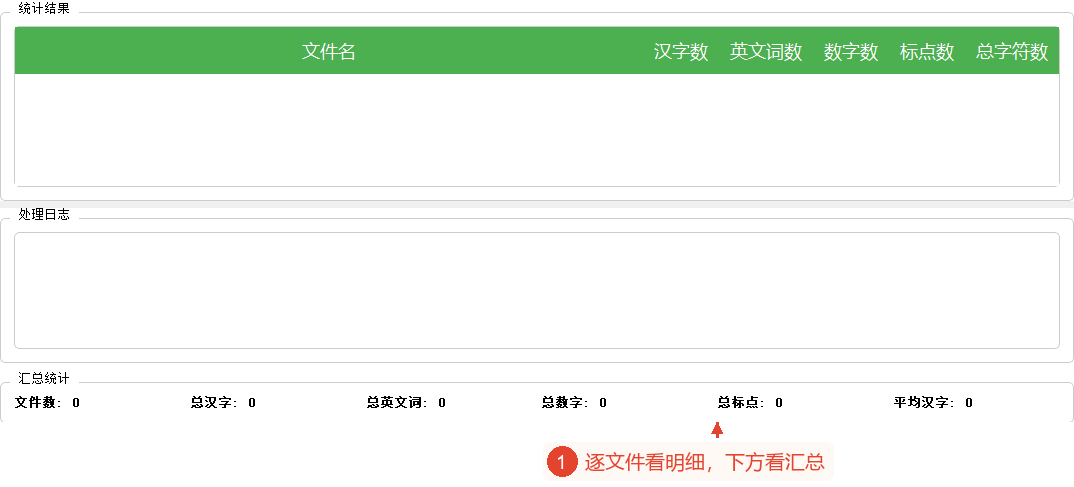
“统计结果”的每一行显示文件名、中文字符数、英文单词数、数字数、标点符号数、总字符数。中文字符在U+4E00至U+9FFF范围内统计;英文按每个A~Z或a~z字母的连续串计数一次,数字按每个连续数字串计数一次;例如,连续的年份数字串计为1,而不是逐个数字计数。
标点符号仅统计中文和英文标点符号的内置列表;总字符数测量去除换行、回车、普通半角空格后的长度,但制表符、全角空格等并非全部按同一规则排除。因此,不能简单相加这些列来得到总字符数,也不等同于Word的字数。
底部“汇总统计”的文件数是成功创建的记录数,而不是来源候选总数;未发生错误但提取到空文本的文件,也可能以0值记录。平均中文字符数为中文字符总数除以记录数,并舍去小数部分。
“处理日志”显示读取失败、缺失的组件、保存路径,保存后显示“结果已保存”。表格提供按列标题排序的功能,运行期间的自动排序可能影响行的显示,因此正式归档适合使用导出的Excel或CSV文件中的完整路径明细。本教程不构建统计结果,仅展示空表格和0值布局。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 遍历子目录 | 包含所有层级的文档 | 默认不勾选。 |
| 文件类型 | 13种扩展名,默认全选 | 请至少选择一种;没有自定义扩展名栏。 |
| 导出格式 | Excel/CSV/TXT,在结束处理期间自动保存 | Excel或CSV保留各文件的完整来源路径。 |
| 并行线程 | 2、4、6、8,默认为4 | 控制读取的并发数,不更改统计标准。 |
| 中文字符数 | U+4E00~U+9FFF内的字符数 | 并不包含所有扩展区块的中文字符。 |
| 英文单词数 | 连续英文字母串的数量 | 不进行自然语言分词或语法识别。 |
| 数字数 | 连续数字串的数量 | 不是单个数字字符的总数。 |
| 标点符号数 | 匹配中文和英文标点符号内置列表的字符 | 不是所有Unicode标点符号。 |
| 总字符数 | 去除回车、换行、半角空格后的长度 | 制表符和全角空格可能被计入。 |
| 平均中文字符数 | 中文字符总数/统计记录数,舍去小数部分 | 使用成功提取的记录作为分母。 |
结果与保存
至少存在一条有效统计记录时,会在结束处理期间自动写入统计结果_年月日_时分秒.xlsx、.csv或.txt。界面没有单独的导出、下载、打开输出目录按钮,请检查保存栏对应的目录;实际保存路径以日志为准。
Excel和CSV两者的逐文件明细均包含文件名、5项统计值、完整来源路径;Excel的汇总包含中文字符、英文、数字、标点符号等的合计,以及平均中文字符数,而CSV末尾的汇总更为简略,仅记载总文件数、中文字符总数、平均中文字符数。TXT列出各文件的名称和5项数值以及主要汇总,不包含完整路径。
DOCX提取正文段落和普通表格,但并不包含所有页眉、页脚、文本框;PPTX读取顶层文本和表格,但不会递归处理组合形状或备注。XLSX读取各工作表中的非空单元格并转换为文本,对于公式,仅使用已有的缓存值,不重新计算公式。PDF仅提取文本层,不对扫描图像进行OCR。
HTML/HTM去除标签;可选解析库可用时,Markdown先转换为HTML后再去除标签,否则直接统计原始文本。DOC的回退读取可能混入二进制数据的可打印字符,不能作为准确的正文文本统计。EPUB当前的章节常量与支持库的接口不一致,日志中可能报告提取错误;RTF和ODT受各自对应的可选组件和可提取范围限制。
停止后的报告可能仅包含已收集的结果,提取失败的文件不会作为错误行自动写入表格;需要另行检查日志。报告文件名仅精确到秒,也没有自动编号机制,请在后续批次中避免同名文件覆盖,并保留所需报告。
常见问题和使用建议
1. 可以直接拖入单个文档进行统计吗?
当前的拖放处理针对文件夹,单个文档需要放入待统计目录,并选择相应类型。
2. 文件类型旁边的“取消选择”会停止任务吗?
不会,它会取消所有格式的勾选,停止任务请使用“停止”按钮。
3. 为什么统计结果有时与Word的字数不同?
本工具按照提取范围和正则表达式标准统计,这些与Word的综合字数规则不同。
4. 数字2026计为4还是1?
连续数字串计为1,页面上的数字数不是位数。
5. 总字符数会排除所有空白字符吗?
仅去除回车、换行、普通半角空格,其他空白字符可能被计入。
6. 可以统计PDF扫描图像中的文本吗?
不可以,不包含OCR,依赖可提取的文本层。
7. 为什么平均中文字符数没有小数位?
使用整数除法,舍去小数部分。
8. 保存位置留空时,输出保存在哪里?
默认保存在主文件夹中,文件名由统计结果和时间戳组成;指定的目录不存在时,会回退到来源的父目录。
9. 为什么停止后仍可能存在报告?
结束处理会自动保存已收集的非空结果集,其范围可能仅为一部分。
10. 清空结果会删除报告吗?
不会,仅清空当前界面的数据,不会停止后台读取任务。