功能关键词:批量URL截图、整页截图、定时截图、截图命名、保存为PNG/JPG/WebP。
工具介绍
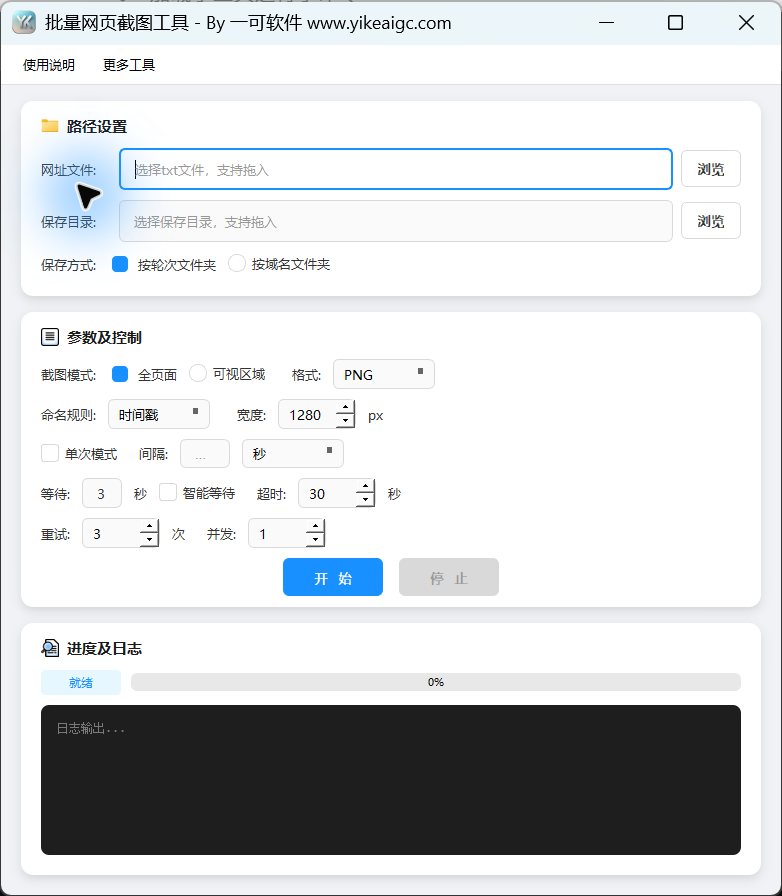
批量网页截图工具读取每行记载一个URL的TXT列表,按设定的页面宽度批量拍摄网页图像,适用于保存网页资料、定期记录页面、归档多个URL。
此页面提供整页或视口选项、3种图像格式、命名方式和子目录方式,以及单次执行、时间间隔、等待、超时、重试、并发数的设置。截图由工具内置的网页引擎拍摄,并非直接复制当前已登录的Chrome页面。
工具截图
主要功能
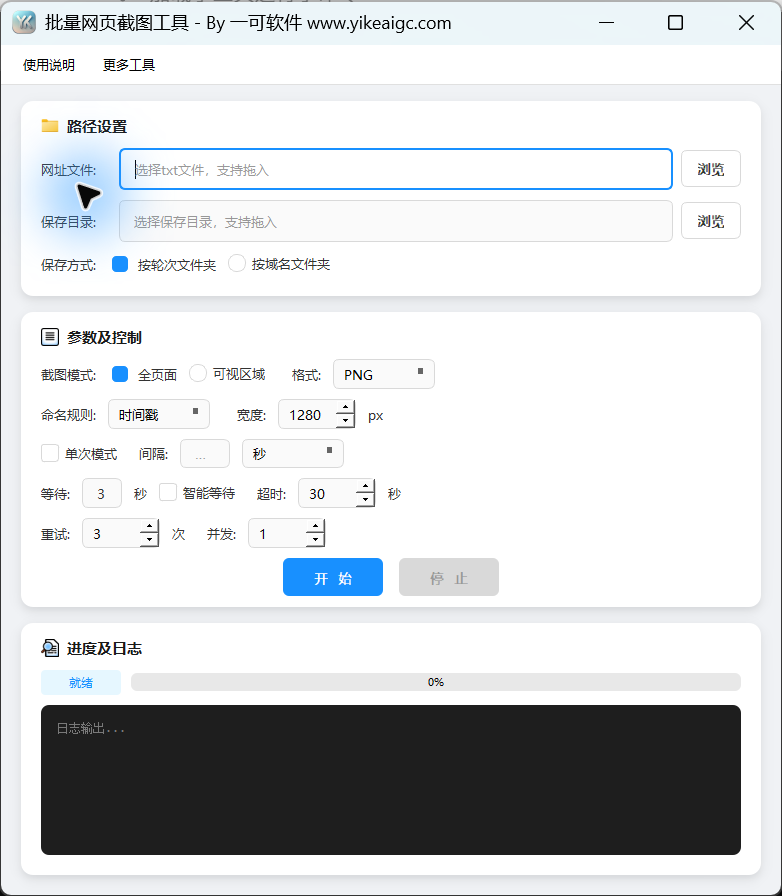
- 从TXT逐行读取URL,忽略空行,并为没有协议前缀的地址添加HTTPS。
- 拍摄整页或固定视口,页面宽度可设置为320至3840。
- 保存为PNG、JPG或WebP,JPG和WebP提供质量参数。
- 命名可选择时间戳、序号、域名+时间或序号+时间,并按轮次或域名创建文件夹。
- 勾选单次执行以执行1轮,或以秒、分钟、小时、天为单位设置重复间隔。
- 设置固定等待或智能等待、加载超时、失败时重试、同时处理的URL数量。
使用前的准备
请准备一个采用UTF-8编码、每行记载一个完整URL的TXT文件;空行将被忽略。请确保地址可从当前计算机正常访问;软件会去除首尾空白,并在没有协议时添加HTTPS,但不保证地址存在。
请准备一个现有的保存目录。通过“浏览”选择URL文件,或拖入文件,保存目录也支持浏览或拖入;此页面没有用于直接逐个粘贴URL的任务列表。
实际运行需要完成软件授权和权限检查。此页面没有浏览器账号、Cookie导入、登录操作、页面元素选择器,因此请不要期待自动复用外部浏览器的登录状态。
详细操作步骤
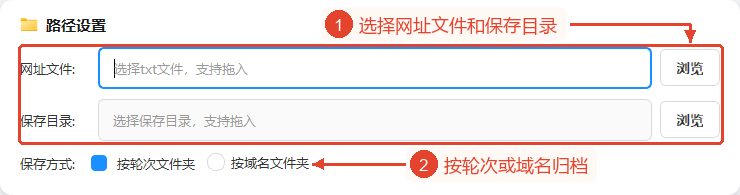
1. 选择URL的TXT文件和保存目录,确定子目录方式
请点击“路径设置 → URL文件”右侧的“浏览”,选择现有的TXT列表,或拖入文件。接着请点击“保存目录”的“浏览”,选择现有文件夹;请不要在保存目录中输入目标图像的文件名。
请在“保存方式”中选择“按轮次建文件夹”或“按域名建文件夹”。前者每轮创建一个年月日_时分秒目录,适合按时间查看同一组URL;后者使用URL的域名创建子目录,便于按网站长期归档。
每轮会重新读取TXT文件,去除空行和首尾空格;不会对重复URL进行去重。无效地址会显示在日志中并被跳过,语法可解析并不意味着一定能打开页面。图中的路径仍为空,尚未加载列表。
2. 选择截图范围、格式、命名和页面宽度
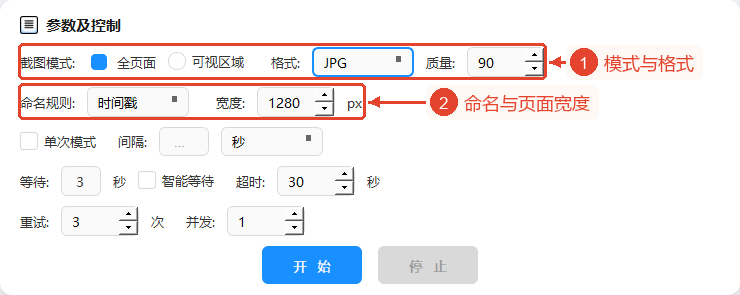
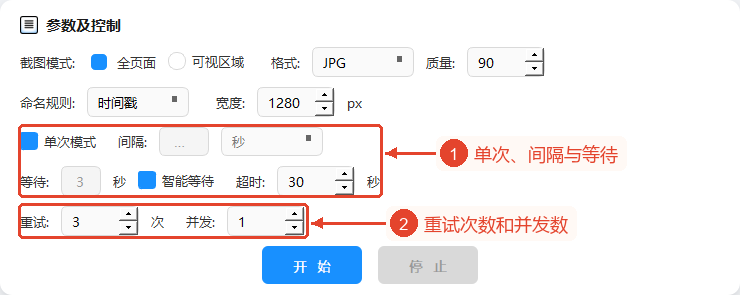
请在“参数与操作 → 截图模式”中选择“整页”或“视口”。整页根据网页高度设置拍摄区域,最小高度为600,最大为30000;即使页面极长,也不会无限扩展。视口使用800的固定高度,此页面没有独立的高度输入框。
请在“格式”中选择PNG、JPG或WebP。PNG不显示质量选项,选择JPG或WebP时会显示“质量”,范围为1至100,默认为90。图中仅为展示此参数而选择了JPG,并未生成图像。
请在“命名规则”中选择时间戳、序号、域名+时间或序号+时间。“序号”每轮从0001开始,时间戳精度为秒;同一秒内的多个目标最初可能生成相同的基本名称,保存时会尝试附加_1、_2等,以避免与现有名称重复。
“宽度”默认为1280,范围为320至3840,控制网页的渲染视口宽度,也可能影响网页的响应式布局。界面上显示的px是设定的宽度,在高DPI环境中原生拍摄的物理像素数可能不同;请不要将此数值视为对所有环境中最终文件尺寸的保证。
3. 设置单次执行或间隔模式,以及等待、重试和并发数
如果只需要拍摄1轮,勾选“单次执行模式”后,间隔值和单位将变灰。默认未勾选状态为重复模式,需要指定正整数间隔,然后选择秒、分钟、小时、天中的一种。点击开始后,先执行1轮,之后每隔指定间隔触发执行;如果上一轮仍在进行,则跳过该次触发,不会追加同一任务的新批次。
未勾选“智能等待”时,网页加载完成后,会按“等待”栏中的整数秒数延迟截图,默认为3秒,也允许为0。勾选智能等待后,此栏会变灰,工具每隔500毫秒比较页面高度,稳定后再等待约500毫秒,最多检查约10秒。根据高度的稳定性进行判断,不会逐一检查图像、API、动画和延迟加载资源。
“超时”范围为5至300秒,默认为30,适用于页面加载,而非整轮的总处理时间;“重试”范围为0至10,默认为3,表示首次失败后的额外重试次数。
“并发数”范围为1至10,默认为1,表示同时加载的URL数量;增大此值会使用更多网页渲染资源。图中仅为展示状态而勾选了单次执行和智能等待,并未执行等待、超时、重试和并发操作。即使使用智能等待,也请保留有效的等待数值,以避免因手动清空或输入非数字内容而导致参数解析失败。
4. 确认后开始,查看进度日志,按需停止
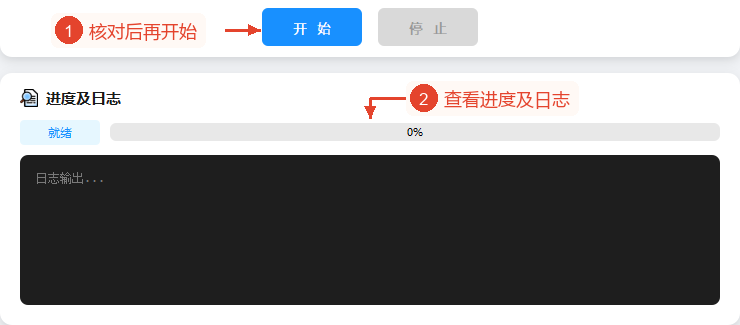
实际使用时,请先确认TXT文件、现有保存目录、保存方式、截图范围、命名、宽度和时间设置,然后点击“开始”。工具会验证权限和路径,读取URL并创建任务;本教程未点击此按钮。
“进度与日志”显示当前轮次的已处理数量、进度、加载、重试、已保存的文件名和统计。进度根据本轮已完成的有效URL数量更新,此状态并不意味着今后所有计划轮次均已结束。
单次执行模式在1轮结束后进入停止状态,重复模式则继续等待下一轮。如果需要停止后续轮次和当前正在加载的页面,请点击“停止”;已写入的图像不会回滚,不保证所有未完成任务都计入最终统计。
完成实际任务后,请在保存目录中按轮次或域名创建的子目录内查看图像。此页面没有结果预览、打开目录按钮或导出日志按钮;可以从日志框中选择并复制文本。退出软件后,定时器和截图管理器将停止。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 保存方式 | 按轮次时间或域名创建子目录 | 长期保存同一网站时,可以选择按域名。 |
| 整页/视口 | 整页高度为600~30000,视口高度固定为800 | 不保证一次拍摄就能完整保存极长的网页。 |
| 格式/质量 | PNG、JPG、WebP,有损格式的质量为1~100 | 默认为PNG,质量默认为90。 |
| 命名规则 | 时间戳、序号、域名+时间、序号+时间 | 定期归档时,可以选择包含时间的规则。 |
| 宽度 | 网页渲染宽度为320~3840,默认为1280 | 请根据所需的网页布局选择。 |
| 单次执行/间隔 | 1轮或按正整数间隔循环 | 首次使用时,可以先选择单次执行。 |
| 固定等待 | 加载完成后延迟整数秒数,默认为3 | 页面异步内容较多时,可以适当增加。 |
| 智能等待 | 根据网页高度的稳定性判断 | 无法保证所有动态资源均已就绪。 |
| 超时/重试 | 加载超时为5~300秒,额外重试为0~10次 | 默认为30秒和3次重试。 |
| 并发数 | 同时处理1~10个URL | 默认为1;资源不足时请保持较低值。 |
结果与保存
图像会直接写入所选目录内按轮次或域名创建的子目录,扩展名由PNG、JPG或WebP的选择决定。如果已存在同名文件,会尝试附加数字后缀;并发任务没有原子性名称预留,不能将此机制描述为在所有并发情况下都绝对避免重名。
日志包含已完成的文件名和成功、失败统计,但保存调用不检查返回的布尔值,因此日志中的完成并不是对文件编码和内容的验证。实际使用时,请按照页面提示检查目录;另外,本教程并未生成或验证实际作业用的截图。
整页拍摄不包含浏览器标签页、地址栏和网站之外的系统桌面;网页本身的登录遮罩、弹窗和尚未加载的内容可能影响图像,此工具没有移除网页上任意遮挡物的设置。
常见问题与使用建议
1. 可以在界面上逐个粘贴URL吗?
此页面的输入是URL的TXT文件;请准备一个每行记载一个URL的现有列表。
2. TXT文件使用什么编码?
源代码使用UTF-8读取,其他编码可能导致读取失败。
3. 没有协议时会怎样?
工具会先添加HTTPS,再解析地址;并不会自动确认页面可访问。
4. 为什么间隔栏是灰色的?
单次执行模式已勾选,只有取消勾选后才能设置循环间隔。
5. 为什么等待秒数是灰色的?
智能等待已勾选,固定等待栏相应地被禁用。
6. 智能等待能保证长页面中的所有图像都加载吗?
不能,它比较的是页面高度,不会主动滚动以触发所有延迟加载。
7. 整页模式可以拍摄任意高度吗?
不能,内部上限为30000;视口高度固定为800。
8. 宽度是最终图像以像素为单位的宽度吗?
这是渲染视口的设置,在高DPI下,原生像素数可能不同。
9. 可以直接使用Chrome的登录状态吗?
此页面没有账号或Cookie导入选项,不会直接拍摄已打开的Chrome标签页。
10. 截图保存在哪里,如何结束循环?
保存到所选的按轮次或域名创建的子目录;点击停止会结束后续计划执行和当前加载,已写入的文件将被保留。