
功能关键词:TXT中文分词、词频分析、TF-IDF和BM25权重、停用词过滤、关键词CSV导出。
工具介绍
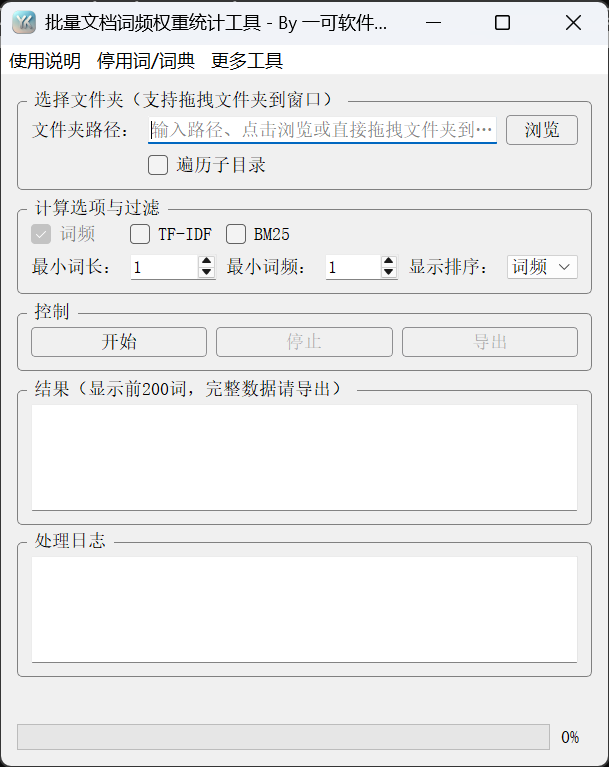
文档批量词频与权重统计工具对文件夹中的TXT文本进行中文分词,统计词频,并根据所选内容汇总计算TF-IDF和BM25权重,适合查看批量处理的文章中的常见词语和比较突出的词汇。
此页面提供最小词长、整批最小词频、停用词管理以及自定义词典管理。结果区域最多显示前200个词,完成后可将完整数据导出为CSV;此工具没有用于搜索的问题或查询词输入框,不是用于检索各文档相关性的界面。
工具截图
主要功能
- 读取单个文件夹中的TXT,可遍历所有子目录,不处理Office、PDF及其他扩展名。
- 使用jieba进行分词,排除空白、指定标点、纯数字词、停用词以及短于所设长度的词。
- 统计整个有效语料库的词频,并可逐文档计算TF-IDF或BM25分数后求和。
- 按整批累计频次排除低频词,结果区域显示保留词中词频最高的前200个词。
- 内置默认停用词,支持添加和删除单个词、从文件合并和加载、导出以及恢复默认。
- 按页面上的格式加载自定义词典,帮助保持专业术语等词语的分词。
- 完成后,按照所选指标、升序或降序以及导出条数,手动保存UTF-8 BOM CSV。
使用前的准备
请准备包含.txt文件的目录;扩展名匹配不区分大小写。可以浏览选择文件夹,也可以拖入文件夹,拖入单个文件时,使用的是该文件所在的目录,而不是仅处理该文件。
如果需要自定义停用词,页面要求使用每行一词的文本文件;自定义词典每行的格式为“词语 词频 词性”,最后两项可省略,请按照页面上的示例直接准备自己的文件。
实际开始时,需要通过登录状态和软件权限检查。输出CSV的位置在处理完成后选择,主界面没有用于预设的保存目录栏。
详细操作步骤
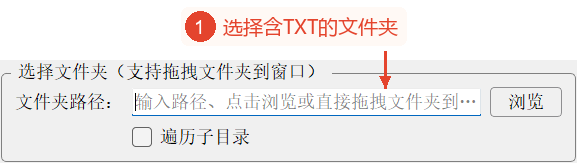
1. 选择TXT目录,决定是否遍历子目录
请点击“选择文件夹”区域的“浏览”选择文本目录,或将文件夹拖入窗口,或直接输入路径。拖入多个项目时仅使用第一个项目,拖入文件时使用该文件所在的目录。
默认仅读取当前层级的.txt文件;如需包含下级目录,请勾选“遍历子目录”。此工具没有格式选择功能,名称中虽有文档,但实际收集范围固定为TXT,不读取DOCX、PDF、CSV等文件。
读取时依次尝试UTF-8、UTF-8 BOM、GBK、GB18030、UTF-16,最终可回退到Latin-1。回退读取成功不意味着中文一定正确,编码信息可在处理日志中查看。
2. 选择权重指标,设置最小词长和整批词频
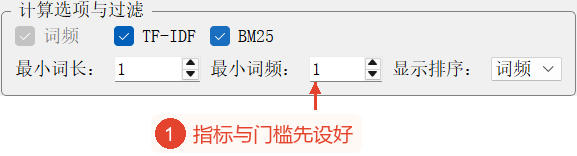
“词频”默认勾选并显示为灰色,表示必须计算,不能取消勾选。如需额外权重,请勾选TF-IDF或BM25;也可以同时启用两者,图中显示的是两者均已勾选的界面状态。
TF-IDF结合单个有效文档中词语的归一化频次与文档稀有度,然后将语料库中各文档的分数相加;BM25也根据各文档的词频、文档长度以及文档稀有度进行计算,然后将分数相加。输出按词语汇总,不提供逐文档的查询相关性排名。
“最小词长”的范围为1至20,默认为1,在分词时删除短词;“最小词频”的范围为1至99999,默认为1,按所有有效TXT文件中的总出现次数进行过滤,并不要求每篇文档都达到此次数。
勾选权重后,“显示顺序”中会添加相应选项。但是,当前计算输出仍按词频降序取前200个词,此下拉框未关联到结果排序;如确实需要按权重排序,请在完成后在导出选项中选择字段。
3. 打开停用词管理,排除不需要的词语
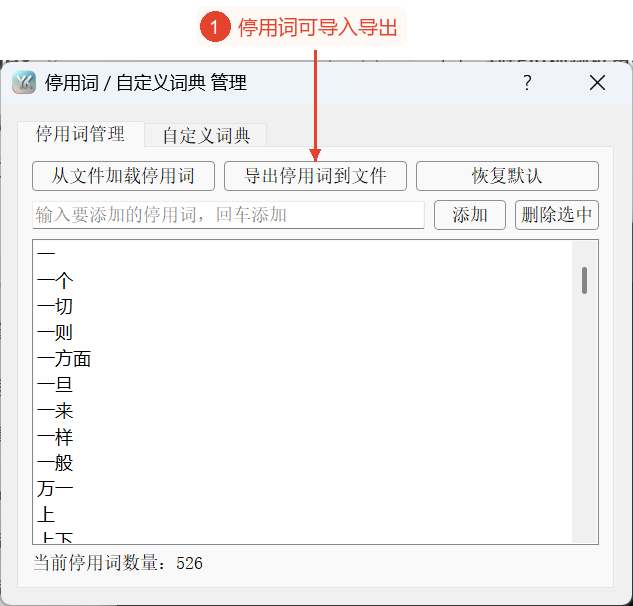
点击顶部菜单的“停用词/词典”,默认进入“停用词管理”。列表显示当前内置词语和会话期间添加的词语,本次默认数量为526,实际数量以窗口底部的显示为准。
对于自有停用词,请在输入框中输入一个词并点击“添加”,或按回车键;列表支持使用Ctrl和Shift多选,点击“删除所选项”后,所选词语将从当前集合中删除。这里删除的是过滤项,而不是源文件。
“从文件加载停用词”按每行一词读取,并合并到当前集合,而不是替换所有默认词语。“将停用词导出到文件”将当前集合逐行保存为UTF-8文本;“恢复默认”在请求确认后恢复内置词语。
停用词针对分词后的完整词语进行匹配,而不是从原始文本中逐字删除。更改仅在当前程序会话中有效,不会随常规设置一起自动保存为自有词表;如需保留,请在实际使用时手动导出。本教程仅打开界面,不添加、删除或加载条目。
4. 根据需要切换到自定义词典,确认词典格式
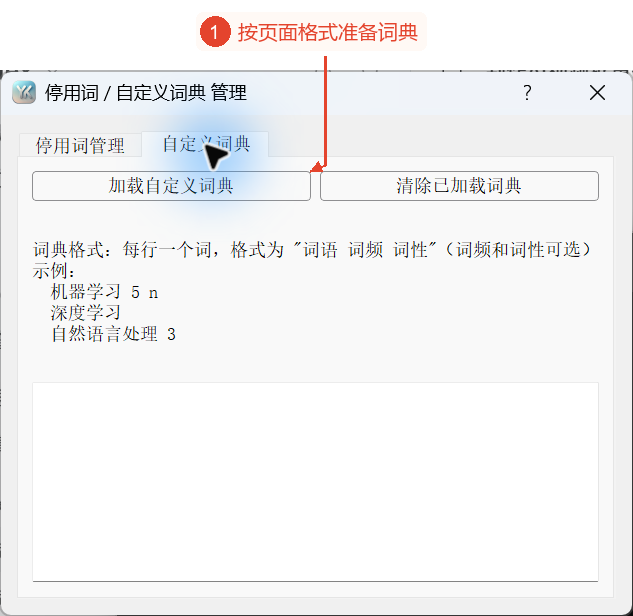
请点击同一管理窗口中的“自定义词典”选项卡。请点击“加载自定义词典”选择自己的文本词典;每行包含一个词,并按照页面上的示例,以空格分隔词语、可选词频以及可选词性。
自定义词典用于影响分词,不直接指定最终统计结果的频次;页面示例中的词频是词典分词的参考值,不是文档中的实际出现次数。停用词和最小长度过滤仍会应用于分词结果。
页面有“清空已加载词典”,用于请求重新初始化分词器;当前管理窗口每次都会新建,已加载文件的状态不会在下次弹出时完整重新显示,因此即使状态为空白,也不一定意味着当前会话从未加载过任何内容。如需完全返回初始会话,可以重启后仅加载此批次所需的词典。
请关闭管理窗口返回主界面,再次确认计算条件和过滤条件。请在开始前设置词典和词表,不要在运行期间调整。本教程不选择词典文件,也不执行初始化或分词。
5. 实际开始后查看前200个词,并手动导出CSV
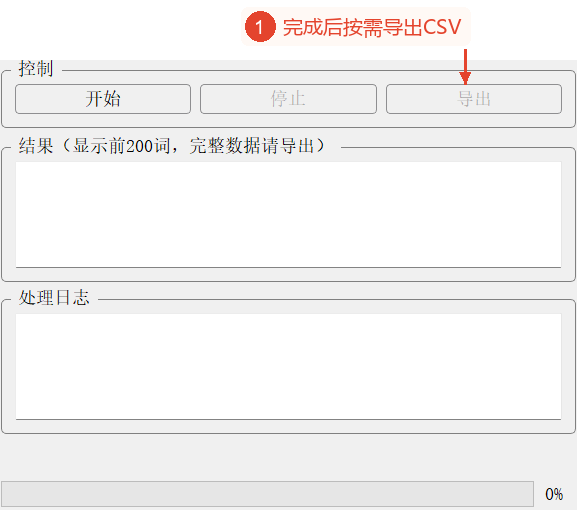
确认目录和参数后,请点击“操作”区域的“开始”。软件进行读取、分词以及统计计算;结果区域按词频降序最多显示前200个词,所选权重与各项并列显示。如需停止,请点击“停止”;请求会在文档处理或权重处理阶段被检查,当前单篇文档的读取或分词可能会先完成。
底部日志记录读取编码、有效词数、无有效词的情况或失败。正常完成后,会显示统计摘要,包括候选TXT数、成功数、失败数、跳过数、总词数以及保留的不同词数;没有TXT文件、所有文件都没有有效词或处理中途停止时,不会将进度强制设为100%。
存在可导出的结果时,“导出”会启用。实际点击后,请先在“导出选项”中选择词频或已计算的权重字段,以及降序或升序;“导出全部数据”默认勾选。如果只需要部分数据,请取消该勾选,并设置“导出前”的条数;默认为500,范围为1至999999。
确认导出选项后,请选择CSV的保存位置。CSV列包含词语、词频以及当前所选权重,权重保留小数点后6位。请在开始前确定指标,不要在完成后临时添加未计算的权重;否则,即使导出界面显示了列,写入的也可能只有0。本教程不启动统计处理或点击导出,也不创建结果。
主要参数说明
| 参数 | 功能 | 建议 |
|---|---|---|
| 词频 | 整个语料库的累计次数,必须计算 | 灰色勾选标记表示始终启用。 |
| TF-IDF | 逐文档计算,然后求和得到词语权重 | 请在处理前根据需要勾选。 |
| BM25 | 考虑词频和文档长度后求和 | 没有查询词或逐文档排名输出。 |
| 最小词长 | 1~20,默认1 | 按分词后的字符数进行过滤。 |
| 最小词频 | 1~99999,默认1 | 整批累计频次阈值。 |
| 显示顺序 | 随指标的添加而添加选项 | 当前显示仍使用固定的词频顺序,导出选择相互独立。 |
| 停用词 | 默认集合和会话期间的更改 | 文件加载为合并,重启后需根据需要重新加载。 |
| 自定义词典 | 词语、可选词频和词性 | 词典参考频次不等于实际统计频次。 |
| 导出条数 | 默认为全部,可限制为前1~999999条 | 仅限制导出,不更改计算结果。 |
结果与保存
完整结果保存在当前会话中,主界面仅显示前200个词;没有自动保存或固定输出目录,保存CSV需在处理后使用“导出”。CSV使用UTF-8 BOM,适合在电子表格软件中查看,权重显示的小数位数与界面上小数点后4位的显示不同。
统计摘要中的总词数已排除停用词、空白、指定标点、纯数字词以及过短词,但尚未按最小词频排除低频词;不同词数是应用最小词频后保留的结果数量,不应直接将这两者理解为同一过滤阶段的数据。
成功文件是至少保留了一个有效分词的TXT文件,无有效词的归为跳过,读取异常归为失败。TF-IDF和BM25的语料库文档数使用有有效词的成功文本,不包含失败文件或无词文件。
大文件按块分词,但读取时仍会先加载全文,并保留语料库的分词集合,因此不应理解为不受内存限制的流式统计。在最终结果汇总前停止时,通常没有可导出的完整结果。
停用词和词典管理仅影响当前会话的分词;重新开始处理后,需要重新计算结果。源文本不会被改写,输出的CSV既不是修订文档,也不是逐文档词频明细。
常见问题与使用建议
1. 可以计算Word或PDF的统计数据吗?
目前仅收集.txt文件,其他扩展名不包含在候选项中。
2. 为什么无法取消勾选词频?
这是必选的基础指标,TF-IDF和BM25是附加选项。
3. 最小词频是指词语在每篇文档中必须出现的次数吗?
不是,过滤依据是整个有效语料库中的总次数。
4. 将显示顺序改为TF-IDF后,界面会重新排序吗?
目前不会重新排序;显示时按固定顺序取词频前200个词,排序字段在导出时另行选择。
5. 停用词文件会替换默认列表吗?
不会,加载时会合并;只有恢复默认才会重置为内置集合。
6. 词典中的数值会成为输出词频吗?
不会,这些数值用于辅助分词,结果词频仍按源文本中的出现次数计算。
7. 结果只显示200条,其他词会丢失吗?
不会,保留的结果可在完成后作为全部数据导出。
8. 为什么词频中不显示数字?
分词过滤会删除符合纯数字规则的词。
9. 为什么导出按钮是灰色的?
尚无可导出结果时会禁用,计算正常完成并得到结果后即可使用。
10. 完成后勾选新权重,可以追加计算吗?
不可以,权重需在处理前选择,临时勾选可能只会在导出时生成零值列。


